

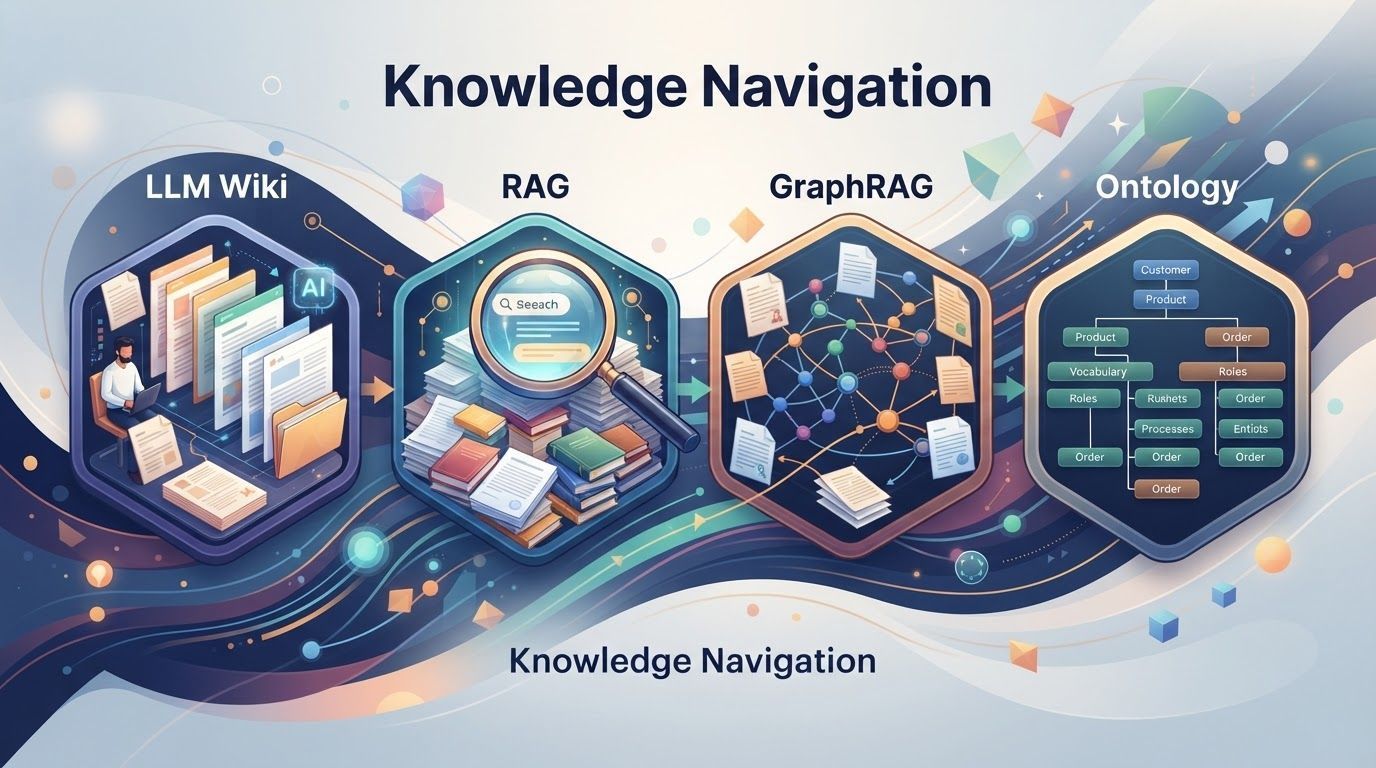
RAG、GraphRAG、LLM Wiki 与 Ontology:四种知识库技术怎么选
四种技术,对应四类问题
做 AI 知识库时,RAG、GraphRAG、LLM Wiki、ontology 经常被放在一起比较。它们都能让 AI「用上资料」,但解决的问题并不相同:有的负责把资料整理成可维护的知识页,有的负责在大量文档里找到相关片段,有的负责把分散的实体和关系串起来,还有的负责让多个业务系统用同一套概念说话。选型的关键不是哪个名字更新,而是先看自己的数据长什么样、要 AI 回答哪类问题。
四种知识库技术的分工
| 技术 | 核心动作 | 最适合的问题 | 典型场景 |
|---|---|---|---|
| LLM Wiki | 按规则把原始资料整理成互相链接的知识页 | 个人笔记和项目经验如何持续沉淀 | 个人知识库、小团队经验库 |
| RAG | 文档切块、向量化,提问时检索相关片段再生成 | 答案主要落在少数几篇文档里 | 企业制度问答、产品文档助手 |
| GraphRAG | 抽取实体与关系,建成图谱后沿关系检索 | 需要跨多篇文档串联实体、依赖和责任人 | 跨文档关系追踪、复杂业务关联分析 |
| Ontology | 定义对象、属性、关系,把各系统数据映射到统一模型 | 多个系统对同一业务概念理解不一致 | 客户、订单、商品的语义统一与规则校验 |
可以先记住一条粗线:个人知识管理看 LLM Wiki,企业文档问答看 RAG,跨文档关系看 GraphRAG,多系统业务语义看 ontology。它们不是四个互相替代的版本,而是四种不同层次的工具;真实项目里经常需要组合使用。
个人知识库:LLM Wiki 把散落资料整理成可链接的知识页
先看个人场景。我们收藏的文章、写的笔记、项目里踩过的坑,常常散落在不同文件夹。时间一长,自己都记不清某条经验放在哪里;每开一个新的 AI 对话,又要重新介绍背景。LLM Wiki 想解决的就是这件事:让 AI 按一套规则,把零散资料整理成可以持续维护的知识库。
- 原始资料:把收集到的文章、文档和项目记录放进一个原始资料目录,保留原始出处。
- 整理规则:用 AGENTS.md 写清楚 AI 该怎么归类、怎么建立关联、遇到重复或冲突内容怎么处理。
- 知识页:AI 按规则把原始资料写成一篇篇 Markdown 页面,页面之间可以互相链接。 4
知识页不是孤立的摘要。某篇笔记提到一个概念时,AI 可以在对应位置建立链接,把相关页面连起来。之后查询时,AI 不仅能找到当前这篇,还能顺着链接找到相关知识。资料越积越多,这些页面之间就形成一张关联网络。
LLM Wiki 适合什么、不适合什么? 适合个人知识库、小团队项目经验沉淀,以及希望内容可直接阅读和修改的场景:所有页面都是 Markdown 文件,打开就能改,维护成本低。它的强项是「整理与连接」,而不是在上千份制度文档里做高召回率的检索;如果问题需要严格引用原文段落,仍要配合 RAG。这里说的 LLM Wiki 是一种做法,不是某个固定产品。
企业文档问答:RAG 先检索,再生成
切到企业场景。公司有几千份制度、手册和产品文档,员工想知道报销标准或某个技术参数。RAG(检索增强生成)的思路可以概括成一句话:先找资料,再让大模型根据资料回答。 1
RAG 的两个阶段
入库阶段把文档解析、切块、向量化后写入向量数据库;提问阶段把问题也转成向量,检索最相关的片段,连同问题一起交给大模型生成答案。
flowchart LR
    docs["Excel / Word / PDF"] --> parse["解析与切块"]
    parse --> embed["向量化"]
    embed --> vdb[("向量数据库")]
    q["用户问题"] --> qembed["问题向量化"]
    qembed --> search["相似度检索"]
    vdb --> search
    search --> context["最相关片段"]
    context --> llm["大模型生成答案"]
    q --> llm
比如员工问「公司的差旅报销标准是多少」,系统从员工手册里找到对应规定,把原文片段交给大模型组织答案,还可以把引用来源一起返回。这样答案有据可查,模型也不容易凭空编造。
普通 RAG 的优势是成熟、检索快、能处理大量文档,工程上也容易落地。企业内部智能助手、产品文档问答,很多都属于这一类。
它的局限出现在问题不是「某一篇文档里写了什么」,而是「把好几篇文档的信息串起来」的时候。比如项目 A 用了检索服务,检索服务由数据团队维护,问「谁在维护项目 A 使用的服务」——单纯靠文本相似度,系统可能分别找到两份文档,却不一定能把它们接上。这时就需要 GraphRAG。
跨文档关系:GraphRAG 在 RAG 上多加一层图谱
GraphRAG 和普通 RAG 最大的区别,是多了一层知识图谱。它会先从文档中抽取实体和关系,再把这些信息组织成图。实体可以理解为业务里出现的名字:项目、人员、服务、供应商;关系就是它们之间的联系:谁使用什么服务、谁负责维护、谁依赖谁。不同实现的具体做法不一样,有的还会对图做社区分层和摘要;共同点是先抽出实体和关系,再在查询时利用图结构。 2
还是用项目 A 的例子。第一份文档写「项目 A 使用检索服务」,第二份写「检索服务由数据团队维护」。普通 RAG 要分别找到这两份文档,再在生成时把信息拼起来;GraphRAG 则提前抽出两条关系:项目 A → 使用 → 检索服务,检索服务 → 维护方 → 数据团队。提问时从项目 A 出发,沿关系走到检索服务,再走到数据团队,答案就有了路径。
沿实体关系回答跨文档问题
图谱把两份文档中的事实接成一条路径:项目 A 使用检索服务,检索服务由数据团队维护,因此项目 A 使用的服务由数据团队维护。最终答案仍要回到原文证据。
flowchart LR
    a["项目 A"] -->|"使用"| s["检索服务"]
    s -->|"由…维护"| t["数据团队"]
    d1["文档 1:项目 A 使用检索服务"] -.-> a
    d2["文档 2:检索服务由数据团队维护"] -.-> s
要注意,图谱给的是关系线索,不是最终答案。生成时还要结合原始文档证据,说明这条关系出自哪份材料;否则一旦抽取错了,错误会沿着链路传下去。
GraphRAG 的代价也很直接:需要额外做实体抽取、关系识别和图谱构建,数据更新后还要维护图谱;如果实体或关系抽错,可能影响整条检索链路。所以如果只是普通文档问答,没必要一上来就用它。它更适合跨文档查询、多层关系追踪和复杂业务关联分析。
业务语义统一:Ontology 让多个系统说同一种话
LLM Wiki 主要解决知识整理,GraphRAG 主要解决文档间的关系检索。企业还有一个更复杂的需求:让不同业务系统的 AI 真正理解同一套业务关系。这就是 ontology(本体)要处理的问题。 3
Ontology 的核心是三个东西:对象、属性和关系。对象是业务里的实体,比如客户、订单、商品;属性描述对象,比如客户名称、年龄,订单金额、下单时间;关系描述对象之间怎么连接,比如客户下单、订单包含商品。把这些定义清楚,再把不同业务系统里的数据映射过来,就得到一套统一的业务模型。
一个简化的客户—订单—商品本体
| 对象 | 属性 | 与其他对象的关系 |
|---|---|---|
| 客户 | 客户名称、年龄、统一标识 | 下单 → 订单 |
| 订单 | 订单金额、下单时间、状态 | 属于 → 客户;包含 → 商品 |
| 商品 | 商品名称、规格、价格 | 被包含于 → 订单 |
举个跨系统的例子。公司有客户系统、订单系统、商品系统,同一个客户在不同系统里可能有不同的名称和标识。客户买了什么商品,商品系统知道商品详情,但这些数据不一定能直接对上。Ontology 把这些分散的业务概念统一起来,再把各系统的数据映射到同一组对象和关系上。这样 AI 查询「某个客户买了哪些商品」时,不需要猜每个系统里的字段是什么意思,可以按统一业务定义把客户、订单、商品关联起来。
Ontology 不只是用来查。还可以在模型里定义业务规则,让系统根据已有数据和规则做推理校验:比如订单状态变化是否合法、客户等级是否满足某个优惠条件。它解决的不只是数据之间的关联,更重要的是让不同系统对同一项业务拥有统一的理解。
Agent 使用 ontology 的方式,通常是通过 function call(工具调用)。可以把「查询本体」「读取订单」「查询客户」分别封装成工具,把工具名称、参数和用途描述清楚,交给 Agent。用户提问后,Agent 根据问题和工具描述判断该调用哪个:只是查物流状态,就调用物流查询工具;要查客户、订单、商品的复杂关系,就调用本体查询工具。工具返回结果后,再交给大模型组织语言。
所以两者的分工很清楚:ontology 负责定义企业的业务概念和关系,Agent 负责理解用户需求、选择工具并完成查询处理。没有 ontology,Agent 面对多个系统时只能靠猜字段;没有 Agent,本体也很难被自然语言直接使用。
两个「图谱」不是一回事
这里有一个很容易混淆的地方:LLM Wiki 和 GraphRAG 都会形成「图谱」,但它们不是一回事。
两种「图谱」的区别
| 维度 | LLM Wiki | GraphRAG |
|---|---|---|
| 图谱从哪里来 | AI 整理资料时,在知识页之间建立链接 | 从原始文档中抽取实体和关系 |
| 节点是什么 | 一篇知识页或一个概念 | 一个实体,比如项目、人员、服务 |
| 边是什么 | 页面之间的引用与关联 | 实体之间的具体关系,比如使用、维护、依赖 |
| 主要用途 | 组织与浏览个人知识,顺着链接扩展阅读 | 支持跨文档的关系检索和路径追踪 |
| 更新方式 | 改 Markdown 文件,让 AI 重新整理 | 重新抽取实体关系并维护图谱 |
一句话概括:LLM Wiki 是把知识连接起来,GraphRAG 是把实体和关系组织起来。前者更像一张由笔记和概念组成的目录网,后者更像一张可用于查询的业务关系图。两者可以同时存在,但不能互相替代。
怎么选:先看数据,再看问题
把四种技术放在一起,选型可以按问题倒推。先问「AI 要回答什么」,再问「数据在哪里、是什么形态」,最后才看需要哪种技术。
从问题出发选技术
| 你的问题 | 优先考虑 | 原因 |
|---|---|---|
| 想让 AI 整理个人笔记、沉淀项目经验 | LLM Wiki | 需要的是可持续维护、可读可改的知识页 |
| 企业文档多,员工要快速查到准确答案 | RAG | 答案通常落在少量文档片段里,检索成熟、成本低 |
| 要跨多篇文档追踪实体、依赖和责任人 | GraphRAG | 需要沿实体关系把分散的事实串起来 |
| 多个业务系统对同一业务概念理解不一致 | Ontology | 需要统一对象、属性和关系,并支持规则校验 |
| 既要查文档,又要跨系统关联和复杂关系分析 | 组合使用 | 没有一种技术同时覆盖文档检索、关系追踪和业务语义 |
一个常见的组合架构
数据库保存实时业务数据,RAG 检索制度和产品文档,GraphRAG 处理复杂关系,ontology 统一核心业务语义,Agent 根据用户问题调用不同能力,最后由大模型组织答案。
flowchart TB
    user["用户问题"] --> agent["Agent"]
    db[("业务数据库")] --> agent
    rag["RAG:制度与产品文档"] --> agent
    grag["GraphRAG:跨文档关系"] --> agent
    onto["Ontology:统一业务语义"] --> agent
    agent --> llm["大模型组织答案"]
知识库选型最重要的,不是哪个技术更新、更热门,而是先搞清楚两件事:自己的数据是什么形态,需要 AI 回答什么问题。数据是个人笔记,先考虑 LLM Wiki;是大量非结构化文档,先考虑 RAG;文档之间有明显实体关系,再考虑 GraphRAG;有多个业务系统和统一语义需求,才轮到 ontology。顺序反过来,很容易为了用新技术而造一个用不上的图谱。
什么时候不该上 GraphRAG 或 ontology? 如果问题只是从几篇文档里找一段规定,普通 RAG 的性价比最高。GraphRAG 需要额外的抽取、建图和维护,抽取错误还会沿链路传播;ontology 需要业务方共同定义概念、持续治理映射,投入比前两者更大。先用简单方案验证问题是否真的需要关系推理,再决定要不要升级。