本体、知识图谱、知识库、数据中台,到底有什么区别?
本体、知识图谱、知识库、数据中台这些概念大多早于大模型出现,却在 LLM 时代重新变热。作者用自己搭建的企业知识图谱解释四者的关系,并从入库、查询、可追溯和 Agent 执行四个方面,说明大模型究竟改变了什么。

本体、知识图谱、知识库、数据中台,到底有什么区别?
过去大半年,我接触的东西基本都收进了自己做的一张企业知识图谱里:按方向、具体案例、技术栈、常见问题拆成节点,再用关系把它们连起来。做它的原因很简单——现在讲企业 AI 落地,绕不开本体(ontology)、企业知识库、知识图谱、数据中台这些词,但很多人其实分不清它们到底差在哪。既然说不清,不如直接做一张看得见的图,一看就懂。
先说个可能让人意外的事实:这些东西大部分都不是大模型出来之后才有的。本体和知识库上个世纪就存在了;“知识图谱”这个词是谷歌 2012 年提出来的;数据中台是阿里 2015 年提出来的。那为什么大模型火了之后,它们又突然被反复提起?要回答这个问题,得先把概念摆清楚。
本体:一张描述“必须存在什么”的骨架
“本体”这个词一听就让人头大。用一句话概括:企业本体描述的是这家企业在某个方向上客观需要存在的架构——这个架构里有什么东西、它们之间是什么关系、要遵守什么规则。
拿组织架构举例。A 公司有老板、总监、组长;他们之间是上下级关系;遵守的规则是“你给我发工资,我给你干活”。这三件事合起来,就是一个本体。它是客观存在的,但只是一副空架子和一堆空位。
知识图谱:往骨架里填上具体的人
如果给上面的空位填上具体对象——老板叫张三,总监是李四,组长是王二麻子,一个干活的“牛马”——关系和规则都没变,但这时候它就成了 A 公司组织架构的知识图谱。
差别就在这:本体是骨架,知识图谱是在骨架上指定了具体对象之后的成品。再比如“核心能力”这个词条,本身只是个空位;一旦给它赋上具体的值,再和其他词条组合起来,就是图谱。
知识库和数据中台:把资料变成能调取的东西
知识库更好理解:A 公司里任何形式的资料——文档、制度、手册、案例——沉淀下来,就是知识库。
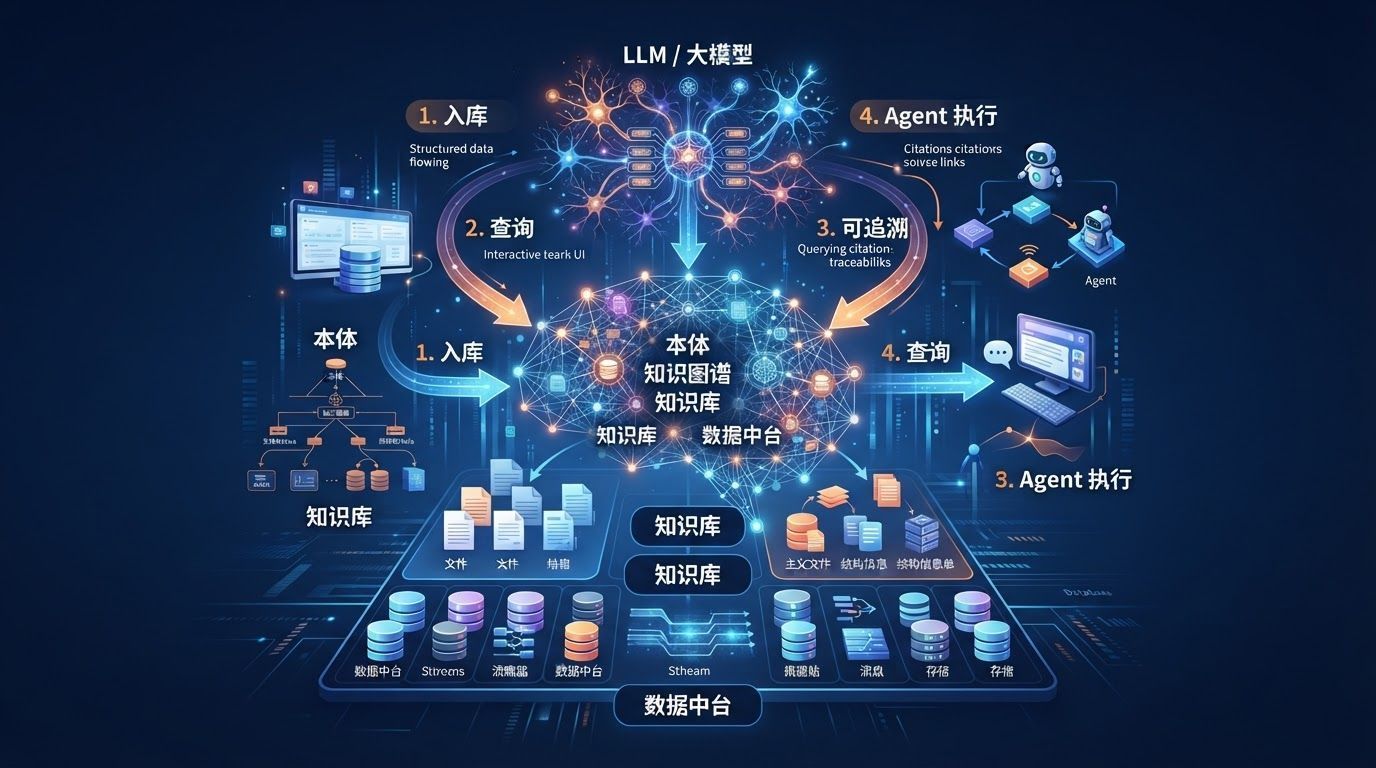
把本体、知识图谱、知识库都做成线上能调取的内容,再接上业务系统的数据,就到了大家常说的数据中台。所以这四件事不是互相替代的关系,而是一层托着一层:本体定结构,图谱填实例,知识库装资料,中台把它们和业务数据接起来。
那为什么大模型一出来,它们又火了?
因为大模型没有让这些概念变新,而是把过去最贵、最耗人的几个环节变便宜了。我自己感受最深的有四点。
一、入库:从“一条条标”变成“丢进去让模型抽”
以前建一个知识图谱有多麻烦?先设计本体,再一条一条标数据,或者写规则;麻烦一点还要专门训练一个命名实体识别(NER)模型。换个行业,这些工作基本得重来。里面还有一件要命的事:实体对齐。
现在不一样了。把文档丢给大模型,它能直接抽出实体和关系,人只需要做审核。我这点资料,三分钟就整理完了。放在以前,需要的人工量让我根本不会有心思去做这件事。
二、查询和输出:不用再为一种问法写一套语句
图谱写好之后,以前的查法是要写专门的查询语句,或者折腾模板,或者训练一个关系抽取模型。换一种问法,可能就查不到了。
现在用大白话问就行。我随手问一个问题,能看到实体链接自动找到了图谱里的关键节点——而我问的这句话,图谱里其实并没有。这就是自动筛选。输出也一样:图谱里没有现成答案,但大模型能自己总结,清楚地告诉你答案。搁以前,它只会把一堆东西全扔给你,自己看。
三、可追溯:企业要的不只是答案,还有答案怎么来的
这一点我觉得最重要。企业 AI 的很多场景,要的不是一个答案,而是这个答案怎么来的、依据是什么;报表要能追溯,结论要能复核。知识图谱天然适合这件事,因为每一条结论都对应着一条关系路径。
在我的场景里,它回答问题时会把用到的路径全部点亮,点开某个节点就能看到这条路径是怎么走的;下面的来源也能回到图谱里对应的节点。答案不再是黑盒,而是有据可查。
四、Agent 的最后一公里,是结构化的数据
现在都在说 Agent,让 AI 不只聊天,还能办事。但 Agent 要办事,前提是它知道你公司的运作模式——这些不是一般文本能说清楚的。
比如设备故障诊断。判断故障的可能还是 FM、神经网络这类算法,但模型判断完之后,是我们建好的这套图谱告诉 Agent:这个故障常见的原因是什么、历史上是怎么修的、设备还有没有备件、对应的负责人是谁。知道这些之后,Agent 再去调用工单系统,把事情变成待办;审核的人一看整个来龙去脉清清楚楚,点个确认,这事就办完了。
最后
这也是为什么,本体这件事最近又被反复提起:它不只让 AI 看懂业务,还要让 AI 在规则内执行。
模型是谁都能买到的。真正拉开差距的,是企业有没有把自己的业务重建成 AI 能理解的结构。