オントロジー、知識グラフ、ナレッジベース、データ中台は何が違うのか?
企業AIの導入で頻繁に登場するオントロジー、知識グラフ、ナレッジベース、データ中台。前世紀からある概念が、なぜLLMの登場で再び注目されたのか。著者が自作した知識グラフを例に四つの違いを整理し、取り込み、検索、追跡可能性、エージェント実行という四つの変化から、その理由を説明する。

オントロジー、知識グラフ、ナレッジベース、データ中台は何が違うのか?
この半年、僕が触れてきたものは、ほぼすべて自分で作った企業知識グラフに詰め込んだ。方向性、具体的な事例、技術スタック、よくある質問をノードに分け、関係でつないでいる。作った理由は単純だ。企業 AI の導入というと、オントロジー、企業ナレッジベース、知識グラフ、データ中台といった言葉を避けて通れないのに、多くの人はその違いを説明できない。ならば、目に見えるグラフをひとつ作ってしまえば、一目でわかる。
まず意外に思われるかもしれない事実から。これらのほとんどは、大規模言語モデル(LLM)が出てきた後に生まれたものではない。オントロジーとナレッジベースは前世紀から存在する。「知識グラフ」という言葉は Google が 2012 年に提唱し、データ中台はアリババが 2015 年に提唱した。では、なぜ LLM が注目されてから、再び繰り返し語られるようになったのか。その前に、概念を整理しておきたい。
オントロジー:「何が存在しなければならないか」を描く骨格
「オントロジー」と聞くと、身構えてしまう。ひとことで言えば、企業のオントロジーとは、ある領域において企業に客観的に存在するべき構造を記述したものだ。その構造の中に何があり、互いにどんな関係を持ち、どんなルールに従うのか。
組織構造を例にしよう。A 社には社長、部長、チームリーダーがいる。関係は上下関係。ルールは「給料を払うから、働く」。この三つを合わせたものがオントロジーだ。客観的に存在するが、実体のない骨格と空席にすぎない。
知識グラフ:骨格に具体的な人を入れる
上の空席に具体的な対象を入れてみる。社長は張三、部長は李四、チームリーダーは王二麻子——現場でこき使われる労働者だ。関係もルールも変わらないが、これで A 社の組織構造の知識グラフになる。
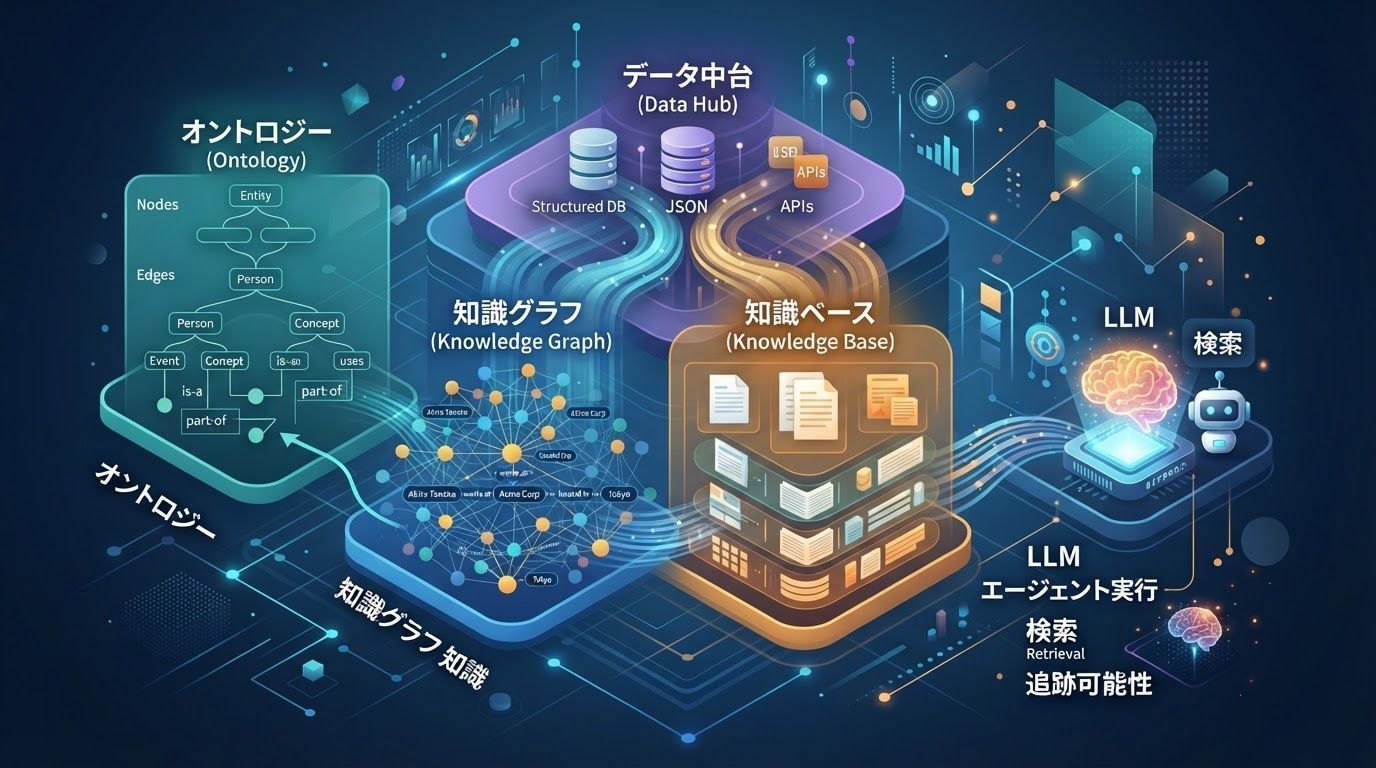
違いはここにある。オントロジーは骨格であり、知識グラフは骨格に具体的な対象を指定した完成品だ。たとえば「中核能力」という項目自体は空席にすぎない。そこに具体的な値を与え、他の項目と組み合わせたものがグラフになる。
ナレッジベースとデータ中台:資料を「取り出せるもの」にする
ナレッジベースはもっとわかりやすい。A 社にあるあらゆる形式の資料——文書、規程、マニュアル、事例——を蓄積したものがナレッジベースだ。
オントロジー、知識グラフ、ナレッジベースをオンラインで取り出せる形にし、さらに業務システムのデータをつなぐ。これが一般にデータ中台(データミドルプラットフォーム)と呼ばれるものだ。つまりこの四つは代替関係ではなく、層になっている。オントロジーが構造を決め、知識グラフが実例を埋め、ナレッジベースが資料を収め、中台がそれらを業務データとつなぐ。
では、なぜ LLM の登場で再び注目されたのか
LLM がこれらの概念を新しくしたわけではない。過去に最も高コストで人手のかかっていた工程を安くしたのだ。僕が特に実感しているのは四点ある。
1. 取り込み:「一件ずつタグ付け」から「放り込んで抽出させる」へ
以前、知識グラフを作るのはどれほど大変だったか。まずオントロジーを設計し、一件ずつデータにラベルを付ける。あるいはルールを書く。面倒な場合は固有表現抽出(NER)モデルをわざわざ学習させる。業界が変われば、これらの作業はほぼやり直しだ。しかも厄介なのがエンティティの名寄せ(アラインメント)である。
今は違う。文書を LLM に渡せば、エンティティと関係を直接抽出してくれる。人間はレビューするだけでいい。僕の資料なら三分で整理できた。以前なら、必要な人手の多さを考えただけでやる気にならなかっただろう。
2. 検索と出力:聞き方ごとに専用のクエリを書かなくていい
グラフを作った後、以前は専用のクエリ文を書くか、テンプレートをこねるか、関係抽出モデルを学習させる必要があった。聞き方を変えると、検索できなくなることもある。
今は普通の言葉で聞けばいい。何気なく質問してみると、エンティティリンキングがグラフ内のキーノードを自動で見つけてくれる。しかも、僕が聞いた文そのものはグラフに存在しない。これが自動的な絞り込みだ。出力も同じ。グラフにそのままの答えがなくても、LLM が自分で要約し、はっきり答えてくれる。以前なら、大量の情報をただ投げ返されるだけだった。
3. 追跡可能性:企業が求めるのは答えだけでなく、その根拠
ここが一番重要だと思う。企業 AI の多くの場面で求められるのは答えそのものではなく、その答えがどこから来たのか、根拠は何か。レポートは追跡でき、結論は検証できなければならない。知識グラフはこれに本質的に向いている。なぜなら、結論の一つひとつが関係のパスに対応しているからだ。
僕の環境では、回答時に使ったパスがすべてハイライトされる。ノードを開けば、そのパスがどう辿られたかがわかる。下部の出典もグラフの対応ノードに戻れる。答えはブラックボックスではなく、根拠を辿れるものになる。
4. エージェントの最後の一マイルは構造化データ
最近はエージェントが話題だ。AI にチャットだけでなく、実際に仕事をさせようという話である。しかしエージェントが動くには、自社の業務の回り方がわかっている必要がある。これは普通のテキストでは説明しきれない。
例えば設備の故障診断。故障を判断するのは FM やニューラルネットワークといったアルゴリズムかもしれない。しかし判断した後、この故障のよくある原因は何か、過去にどう修理したか、予備部品はあるか、担当者は誰かをエージェントに教えるのは、我々が作ったこのグラフだ。それを知った上で、エージェントがワークオーダーシステムを呼び出し、タスクにする。レビューする人は経緯がすべて見えるので、確認を押せば終わりだ。
最後に
だからこそ、オントロジーが最近また繰り返し語られる。AI に業務を理解させるだけでなく、ルールの内側で実行させるためだ。
モデルは誰でも買える。本当に差がつくのは、自社の業務を AI が理解できる構造に作り直せているかどうかである。