我用 Vibe Coding 做了个 Mac 提词器:小工具也值得被认真做完
用 Vibe Coding 做了一个 Mac 字幕提词器:本地 AI 模型负责自动提词,不必边讲边手动滚动;处理留在本机,素材无需先上云,代价是只支持 Apple 芯片 Mac。为了让录制流程不裂成两截,又加了美颜和滤镜。代码已开源,链接放在视频简介,欢迎下载和改写。

支持对已公开的 136 篇文章进行关键词模糊搜索、分类与标签筛选。
用 Vibe Coding 做了一个 Mac 字幕提词器:本地 AI 模型负责自动提词,不必边讲边手动滚动;处理留在本机,素材无需先上云,代价是只支持 Apple 芯片 Mac。为了让录制流程不裂成两截,又加了美颜和滤镜。代码已开源,链接放在视频简介,欢迎下载和改写。
进新公司约一个月,作者发现自己又撞上同一堵墙:有劲儿却发挥不出来。他把原因归结为“言大于行”的组织文化——大家热衷掰扯道理,产品概念多、真正做出来的少。文章从日本客户的磨合方式谈起,主张先修内部,建立每天汇报、共同规划的做事机制,再出去碰机会;并进一步判断,AI 时代软件产品正在贬值,竞争力会转向云与伙伴之间的互相带货,以及洞察并调整人的状态、用叙事激发对方的能力。
本体、知识图谱、知识库、数据中台这些概念大多早于大模型出现,却在 LLM 时代重新变热。作者用自己搭建的企业知识图谱解释四者的关系,并从入库、查询、可追溯和 Agent 执行四个方面,说明大模型究竟改变了什么。
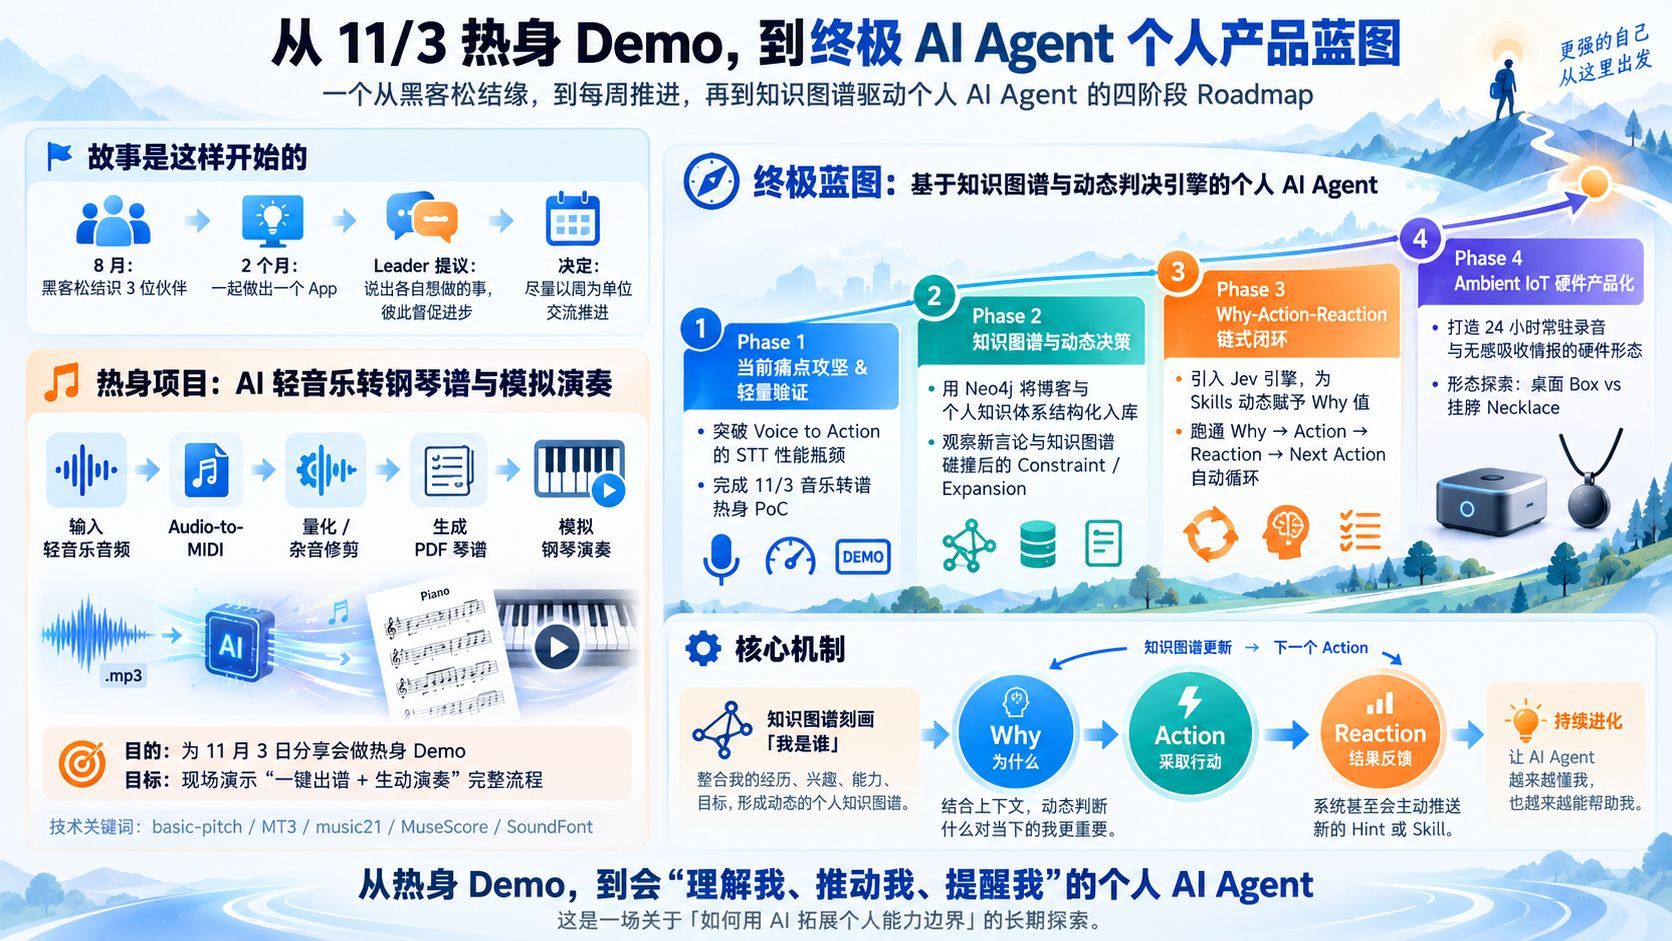
11 月 3 日与朋友的小型分享会前,我先做一个把轻音乐自动转成钢琴谱并模拟演奏的热身 Demo,用它验证音频处理与 MIDI 生成链路。之后回到核心产品:用 Neo4j 知识图谱为 Agent 赋予动态的“Why”,并沿 STT 提速、知识碰撞、Why-Action-Reaction 闭环、Ambient IoT 硬件化四个阶段推进。文章也记录了目前尚未确定的问题与每周推进的方式。
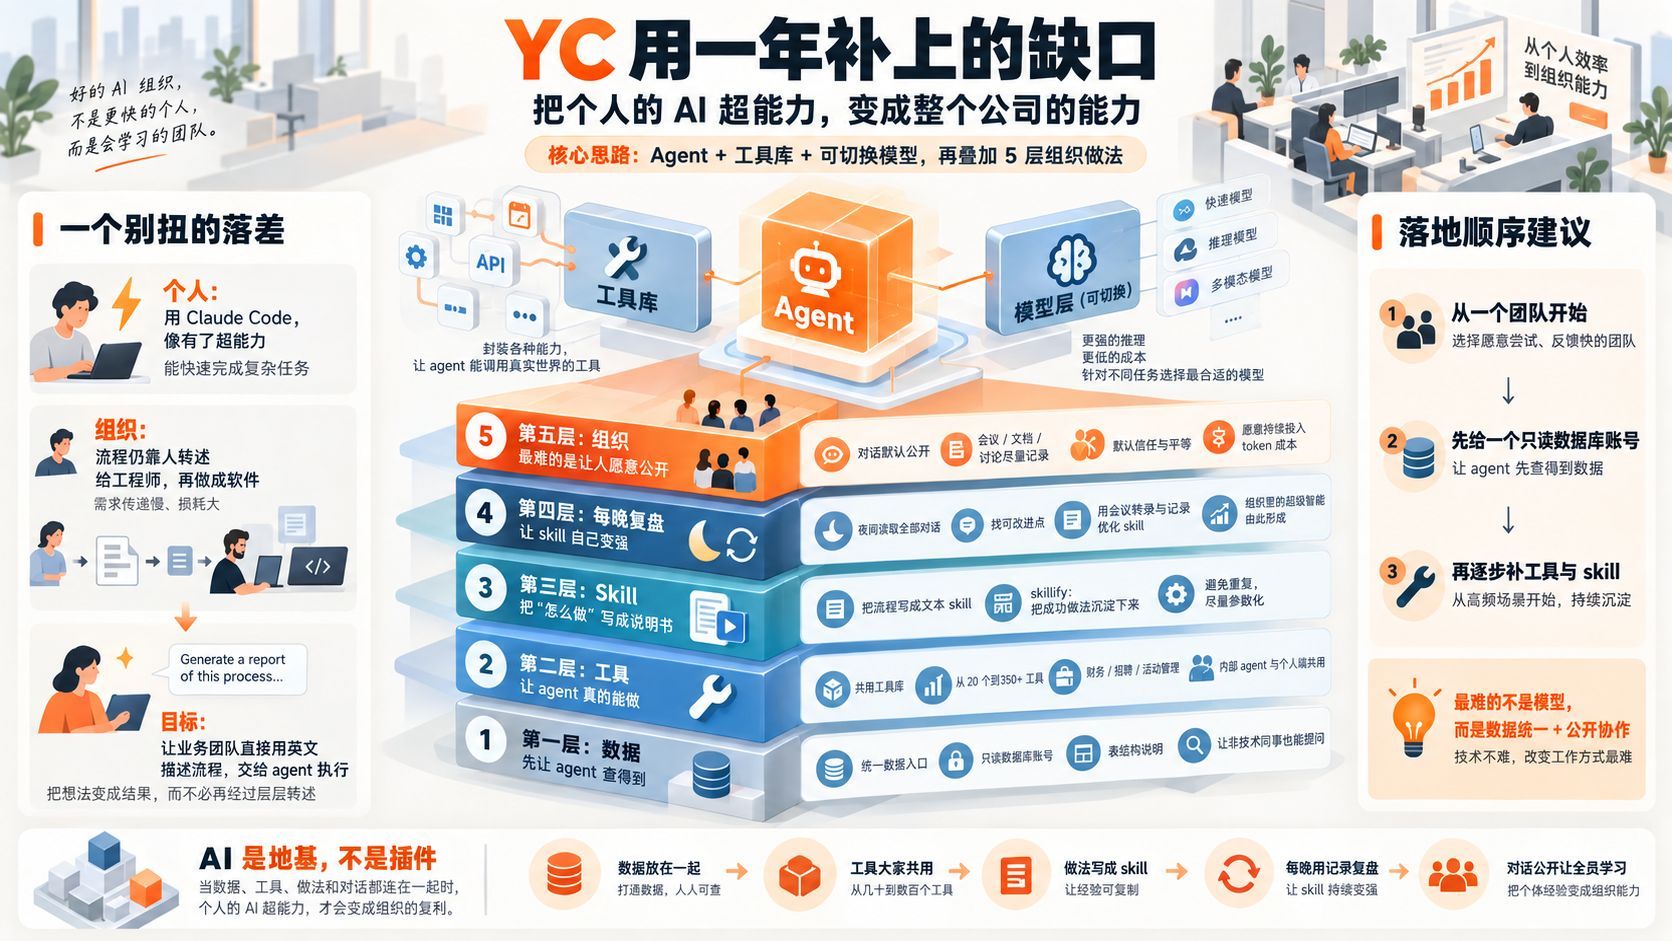
个人用 AI 已经很强,公司整体却没怎么变。YC 花一年搭起五层系统:统一数据、共用工具、把做法写成 skill、每晚用对话记录改进 skill,再把对话默认公开。合伙人 Pete 首次公开这套结构,本文按落地顺序拆解,并指出最难的两层与第一步。
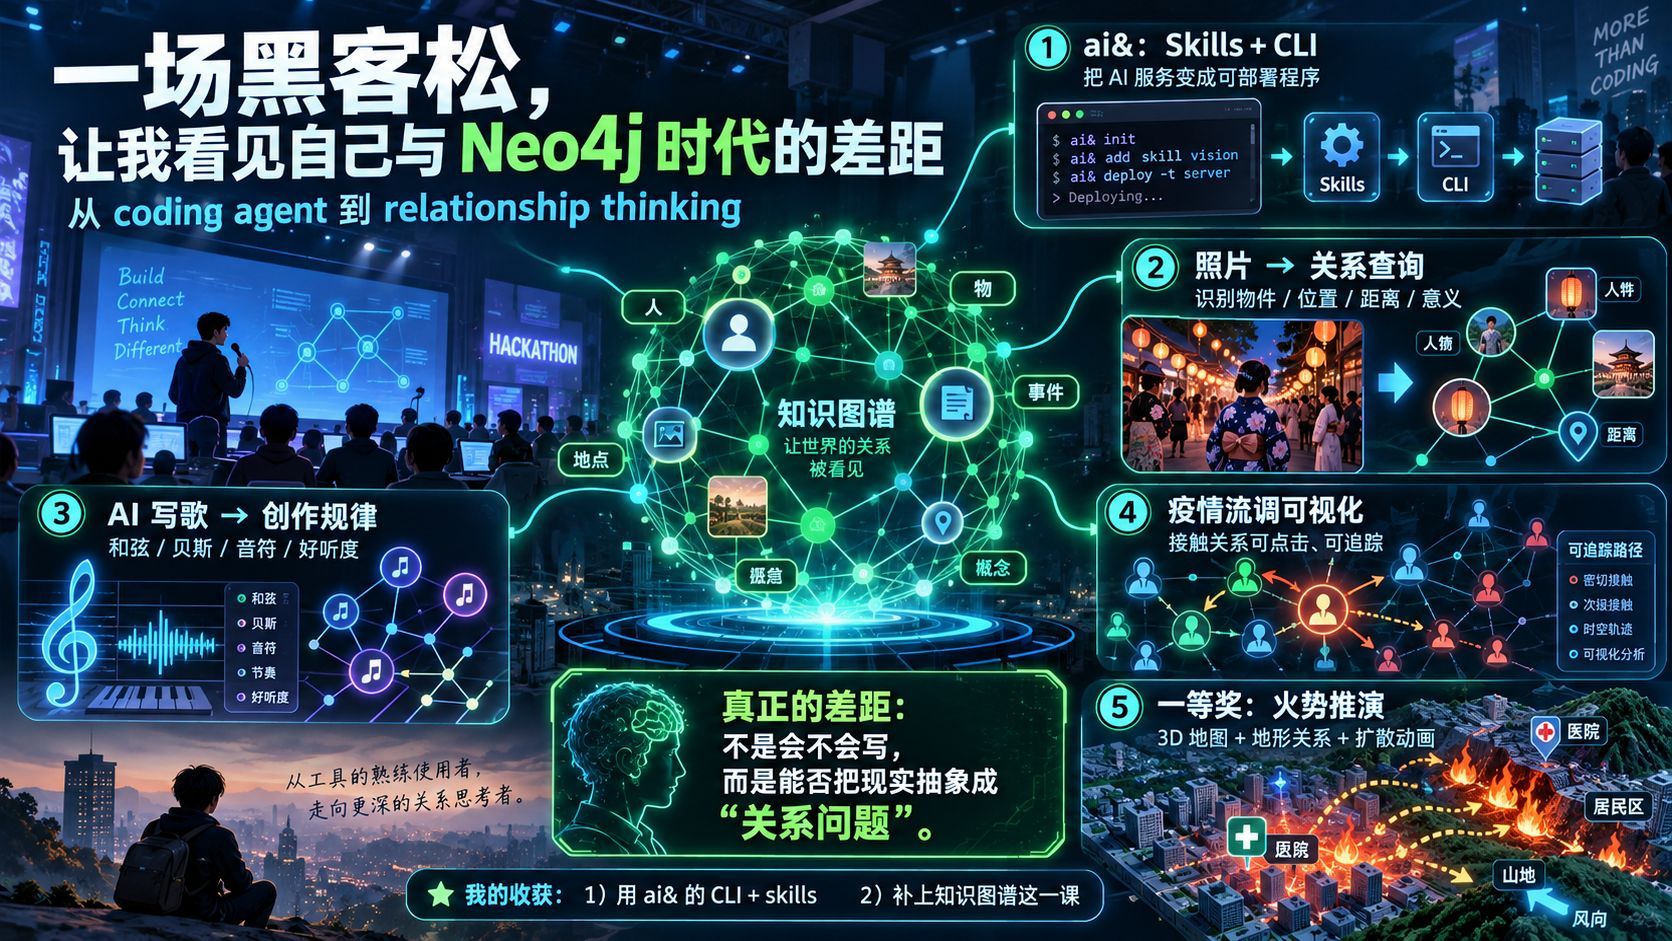
参加 +81 Builders 的黑客松,体验了 ai& 用 CLI 与 skills 把 AI 服务变成可部署服务器的做法,以及 MiniMax 视频生成的速度与低成本;更受冲击的是参赛者四小时内用 Neo4j 做出的照片关系解析、音乐分析、流调动态图谱与火灾推演。作者由此感到,仅靠 coding agent 的熟练已不够,开始补课知识图谱。
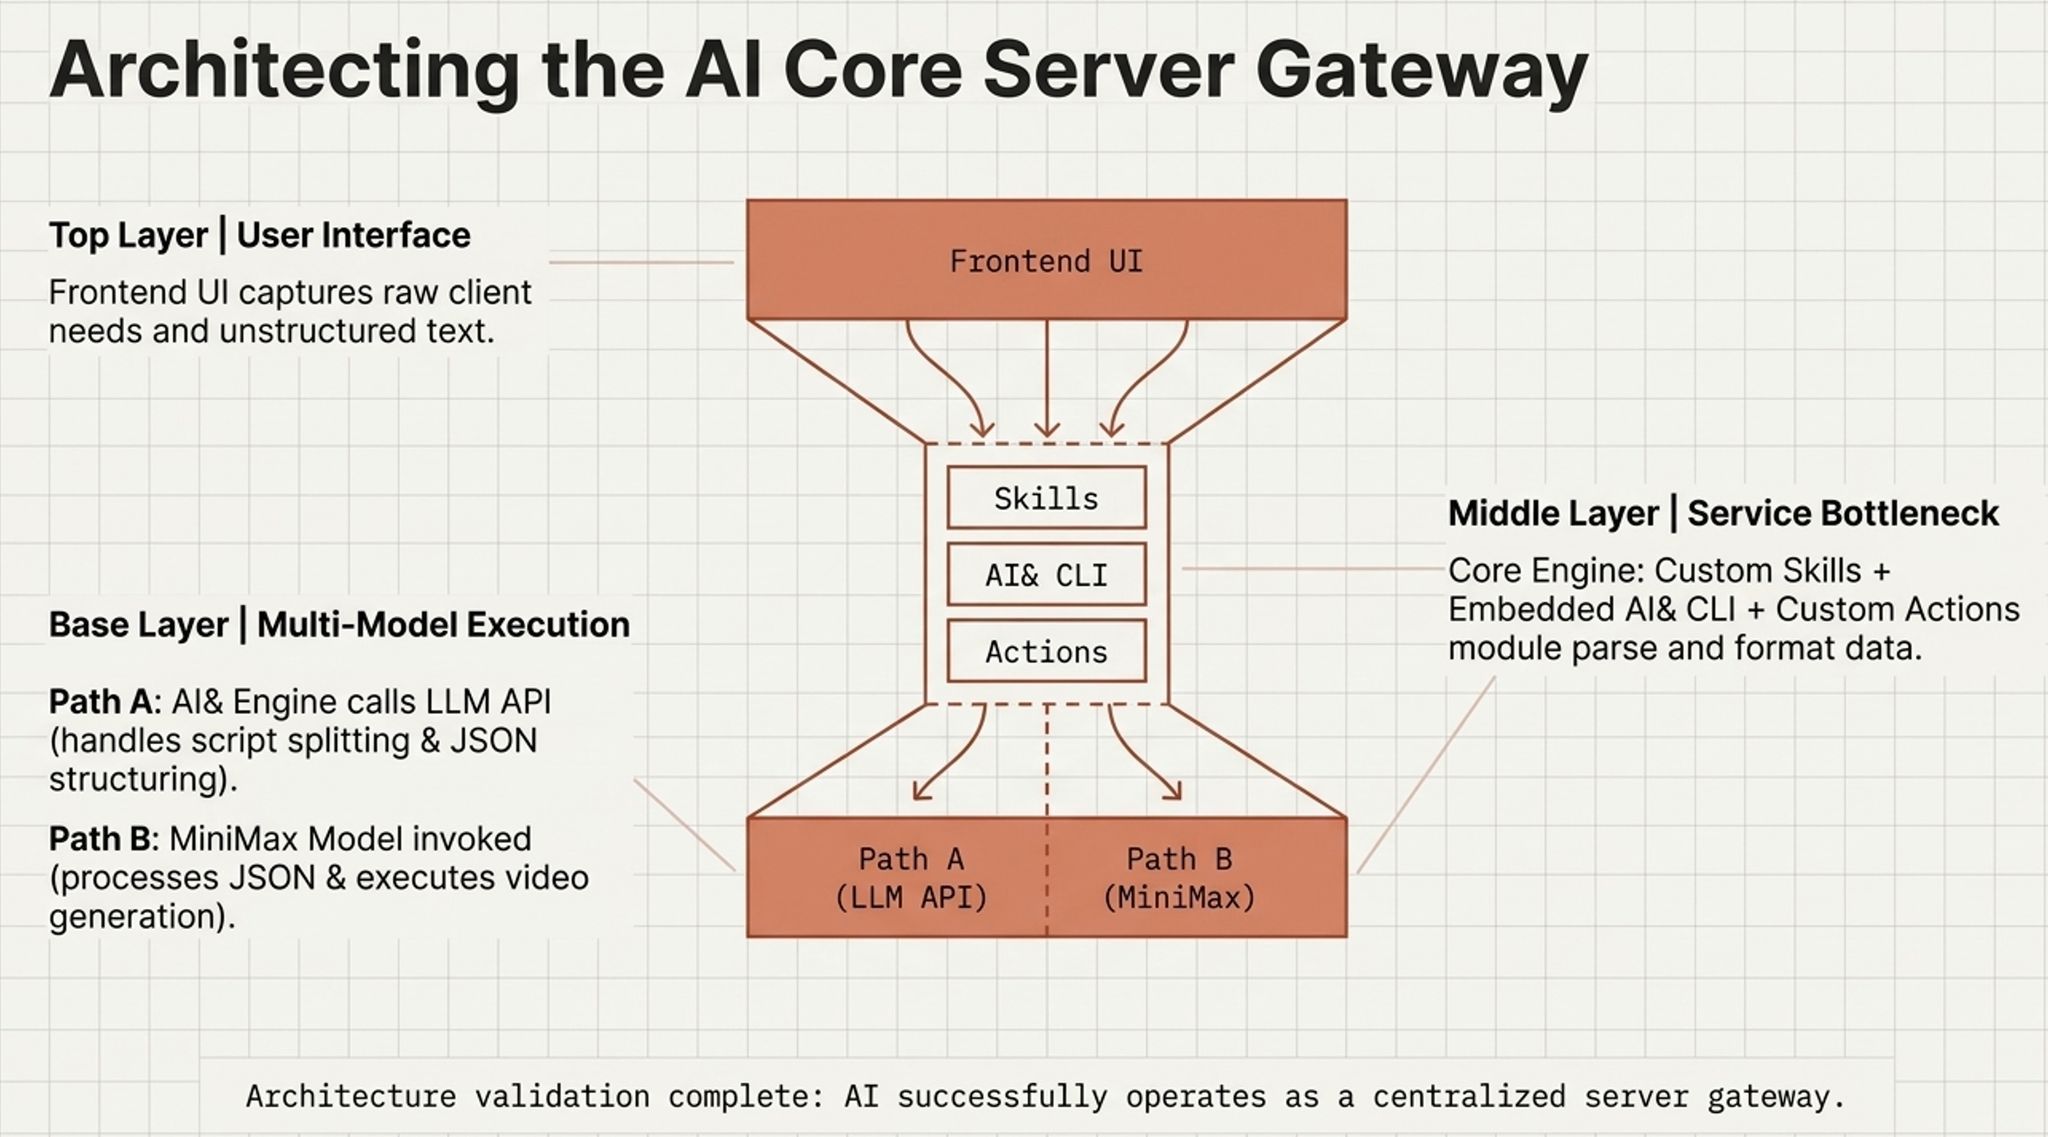
这次黑客松我开发了一套从故事或博客生成视频的工具,并完成了三层验证。第一层把故事自动拆成多节,生成提示词、角色与配音,再逐节生成视频;第二层把 AI& CLI 包装成服务层,用 skills 驱动 AI LLM API,让非程序员也能使用;第三层先写好配音,再以配音为参考让 MiniMax 生成画面,形成声音驱动的视频生成方法。三个验证都成功了。
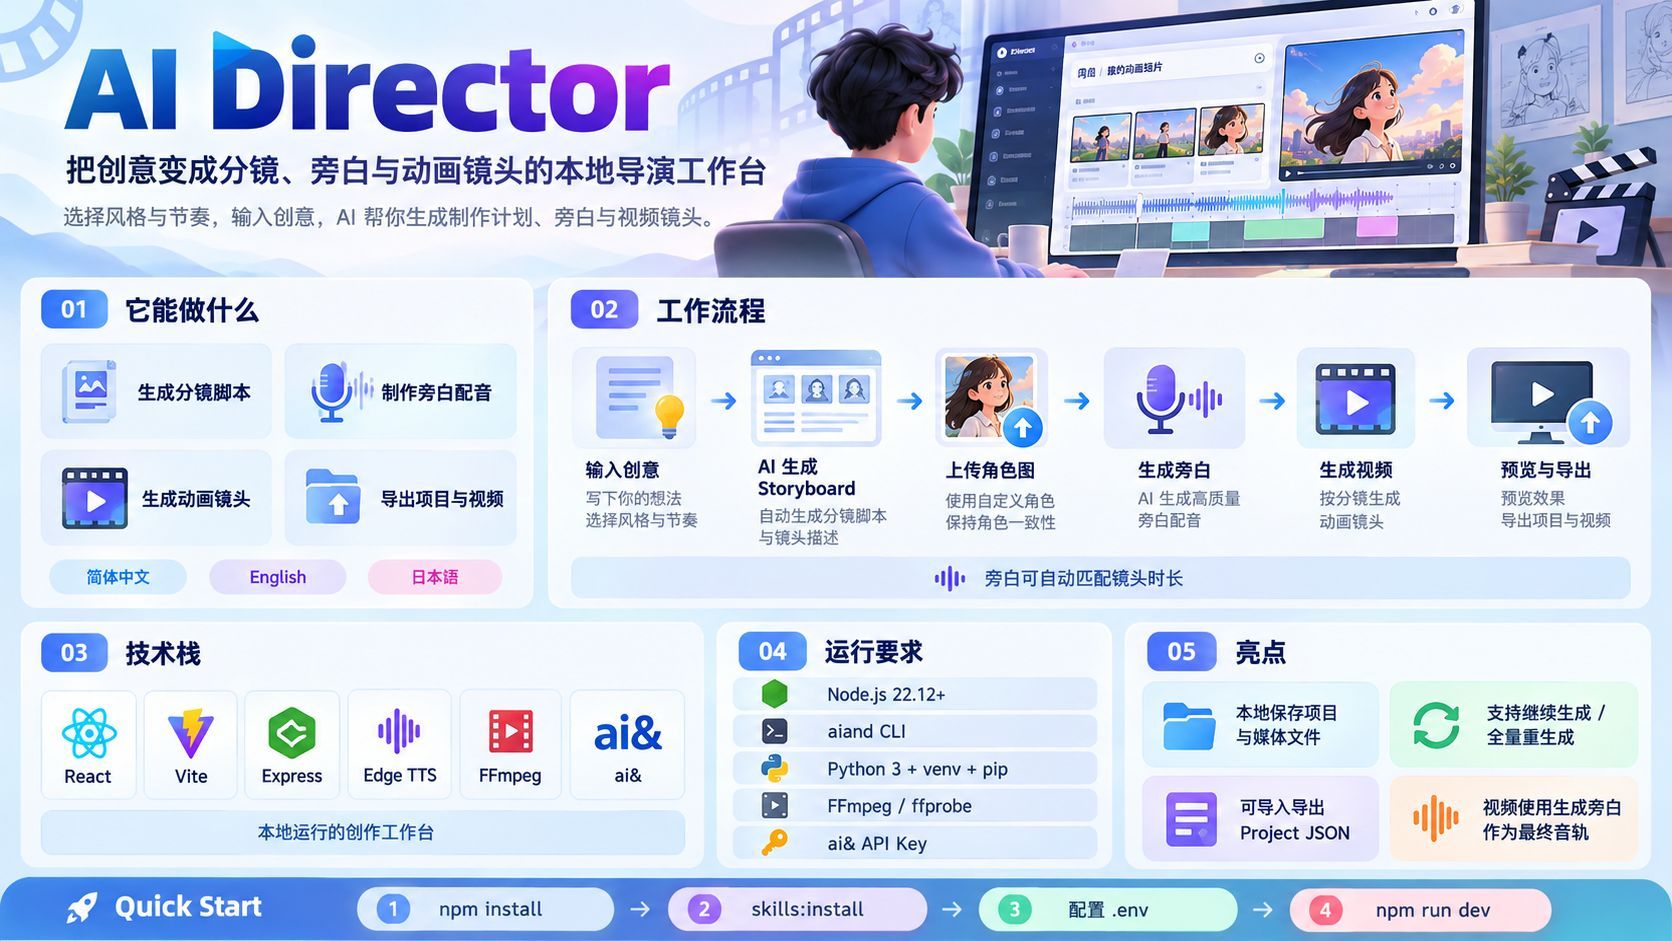
AI Director 是一个跑在本地的导演工作台,把想法拆成分镜、角色、配音和镜头。它用通过校验的项目 JSON 约束 AI 输出,以 Edge TTS 生成旁白并按镜头时长调整语速,再通过 ai& 的 MiniMax H3 生成视频。本文梳理它的制作流程、时间轴处理、付费任务的边界、本地优先的数据设计,以及显式加载并校验 Skill 的工程取舍。
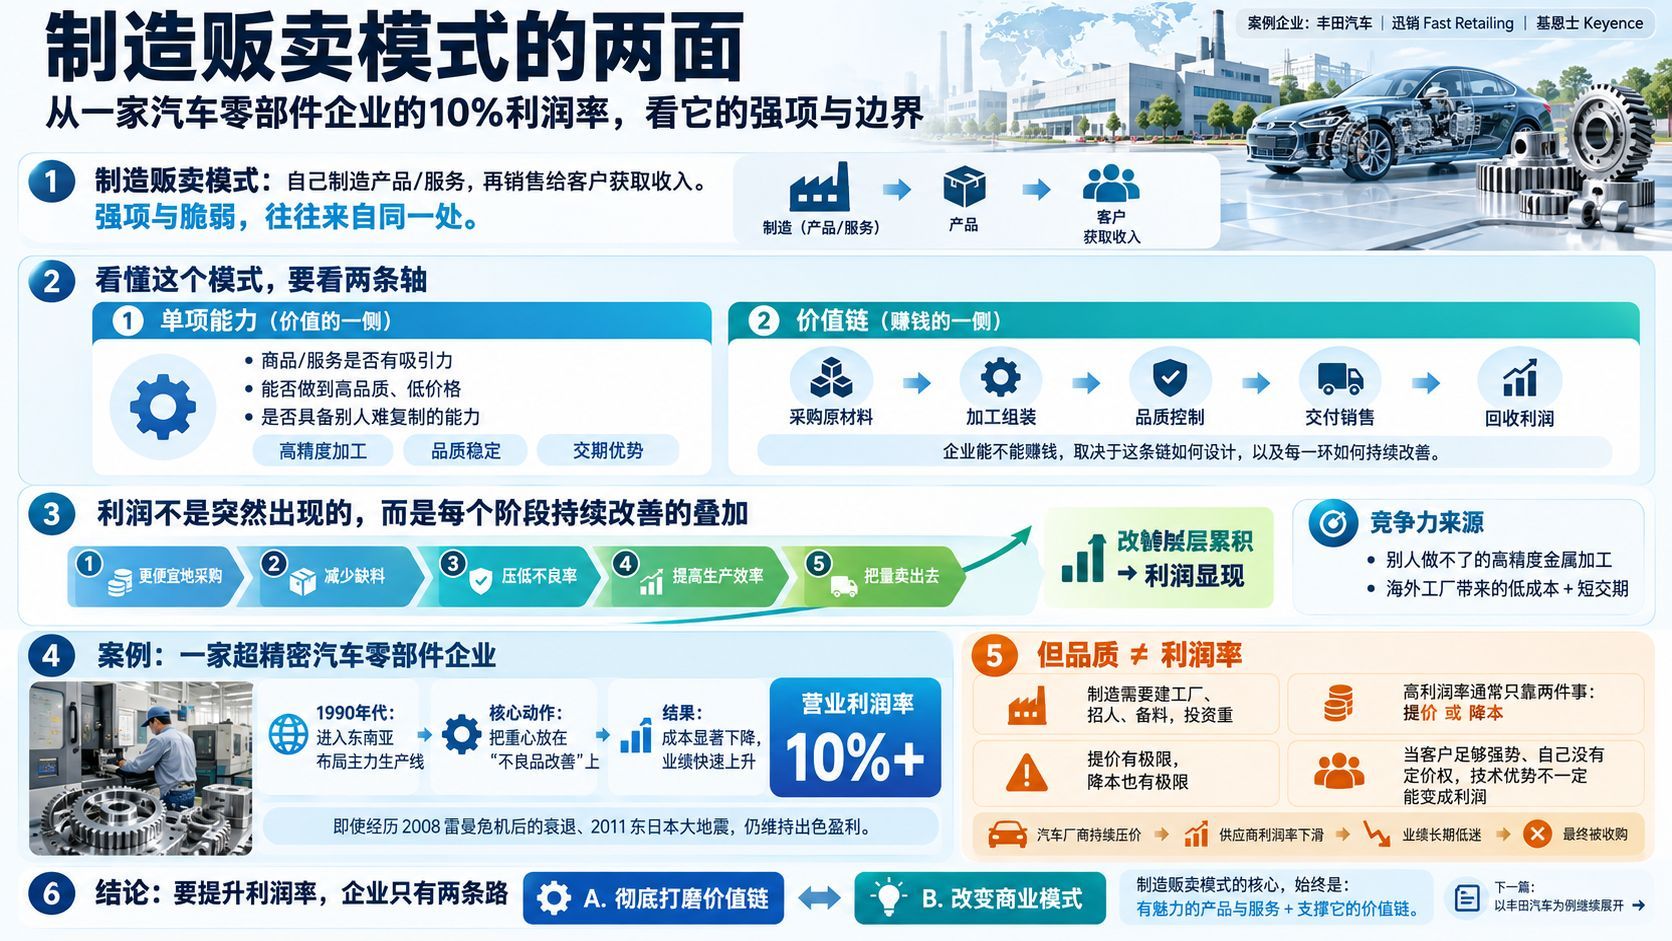
制造贩卖模式看似简单:企业自己制造并销售产品、从客户获得对价,但它的强项与脆弱来自同一处。关键在两条轴——做高品质、低价格、别人做不到的“单项能力”,和在价值链里采购、加工、交付的收入方式。案例中,一家超精密零部件企业因量产不良品长期停滞,1990年代转往东南亚并彻底改善不良,最终在雷曼危机与东日本大地震中仍做到10%出头的营业利润率。但品质和利润率是两回事:无法拒绝客户降价要求的企业业绩难恢复,最终被收购。出路只有彻底打磨价值链,或改变模式本身。
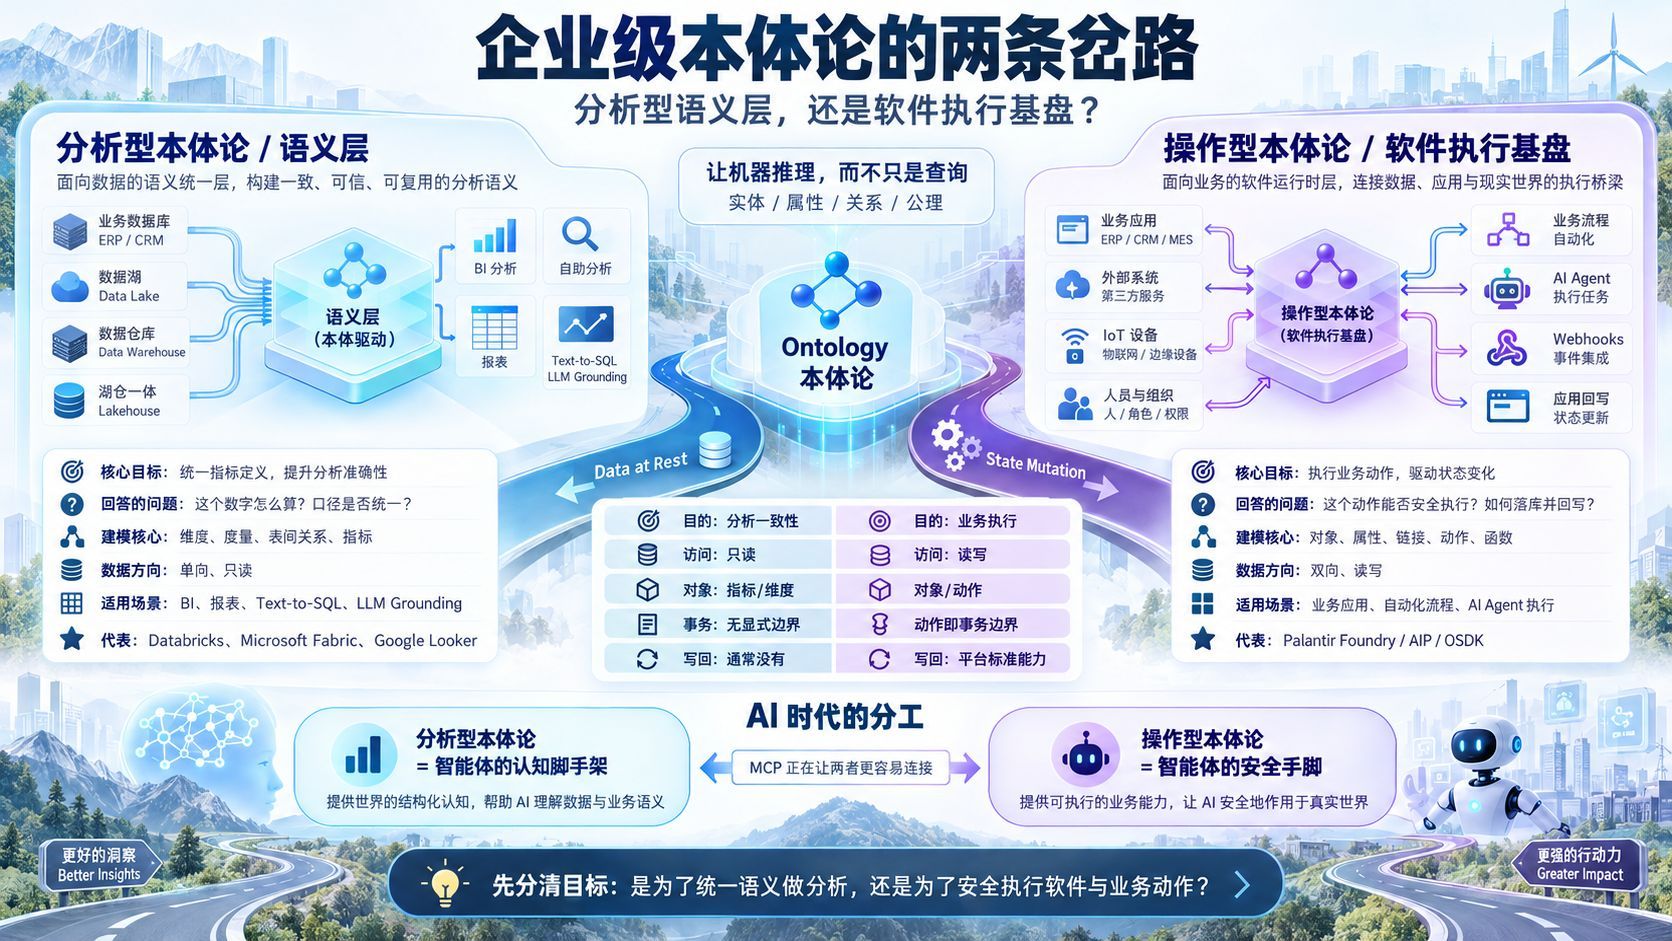
本体论在企业 IT 中分化为两条路线。分析型语义层统一指标定义,以只读方式支撑 BI、Text-to-SQL 与 LLM 的上下文接地;操作型本体论则把状态变更事务、事前校验、外部系统写回与类型安全的 OSDK 代码生成整合成业务应用的执行基盘。Databricks、Microsoft、Google Cloud 的能力本质上是前者的延伸,Palantir 则是后者的代表,并以 CQRS 与决策血缘实现企业级读写分离。本文梳理两者的结构差异、AI 智能体时代的分工,以及企业架构选型矩阵。
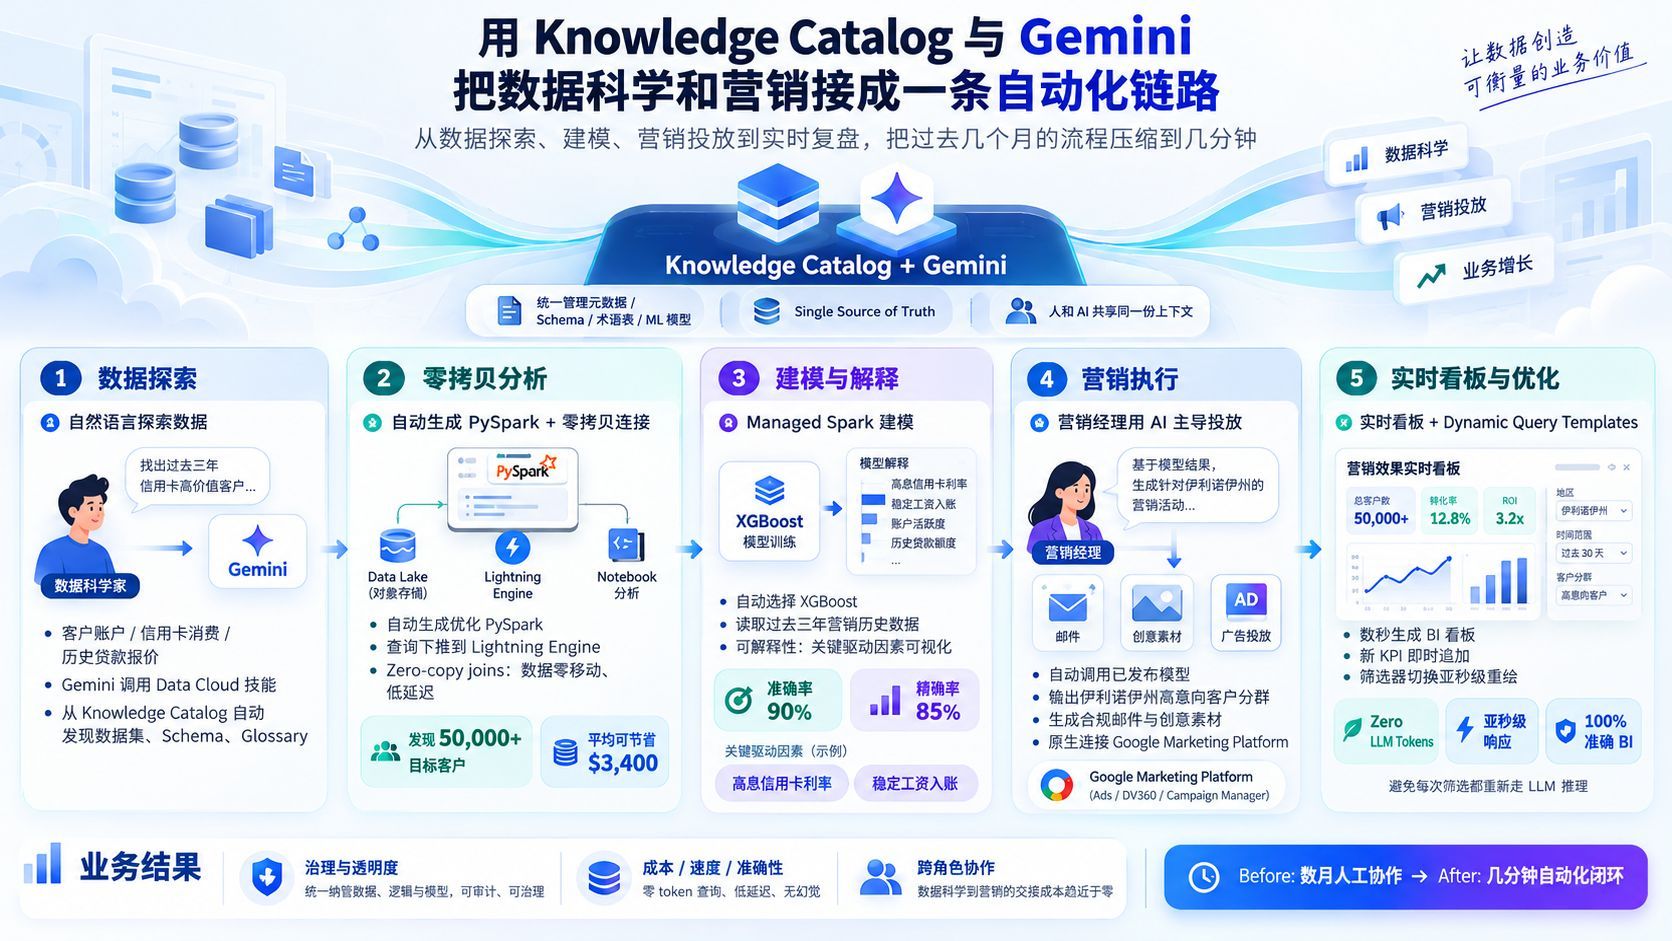
本文以零售银行的贷款置换为例,说明 Knowledge Catalog 与 Gemini 如何打通数据科学与营销:自然语言探索数据、自动生成 PySpark 并经 Lightning Engine 做零拷贝连接,用 XGBoost 建模(准确率90%、精确率85%),一键发布到目录,直至用零 token 的 BI 分析把数月工作压到几分钟。
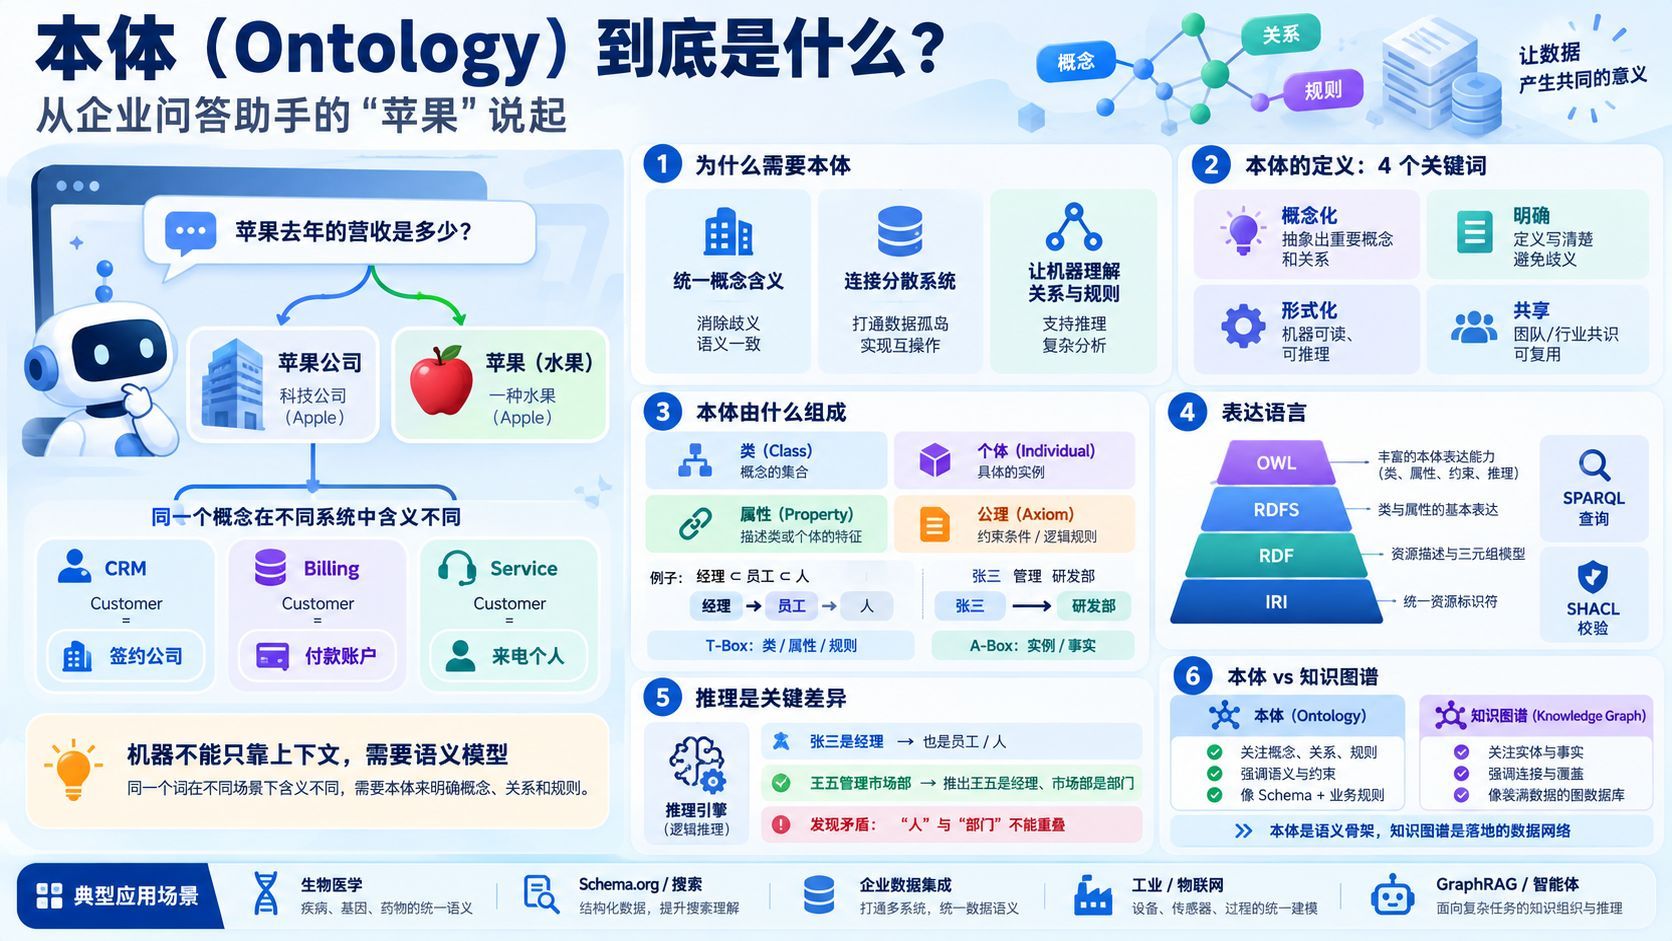
要让企业问答助手分清“苹果”是公司还是水果,并理解三张都叫 Customer 的表,机器需要的不是上下文,而是一个明确的语义模型——本体。本文从哲学起源讲到 Gruber 与 Studer 的定义,拆解类、个体、属性与公理,介绍 RDF、RDFS、OWL 及推理机的作用,梳理生物医学、Schema.org、企业集成、工业物联网和大模型时代的典型应用,并说明本体与知识图谱的区别以及动手构建的方法与常见错误。