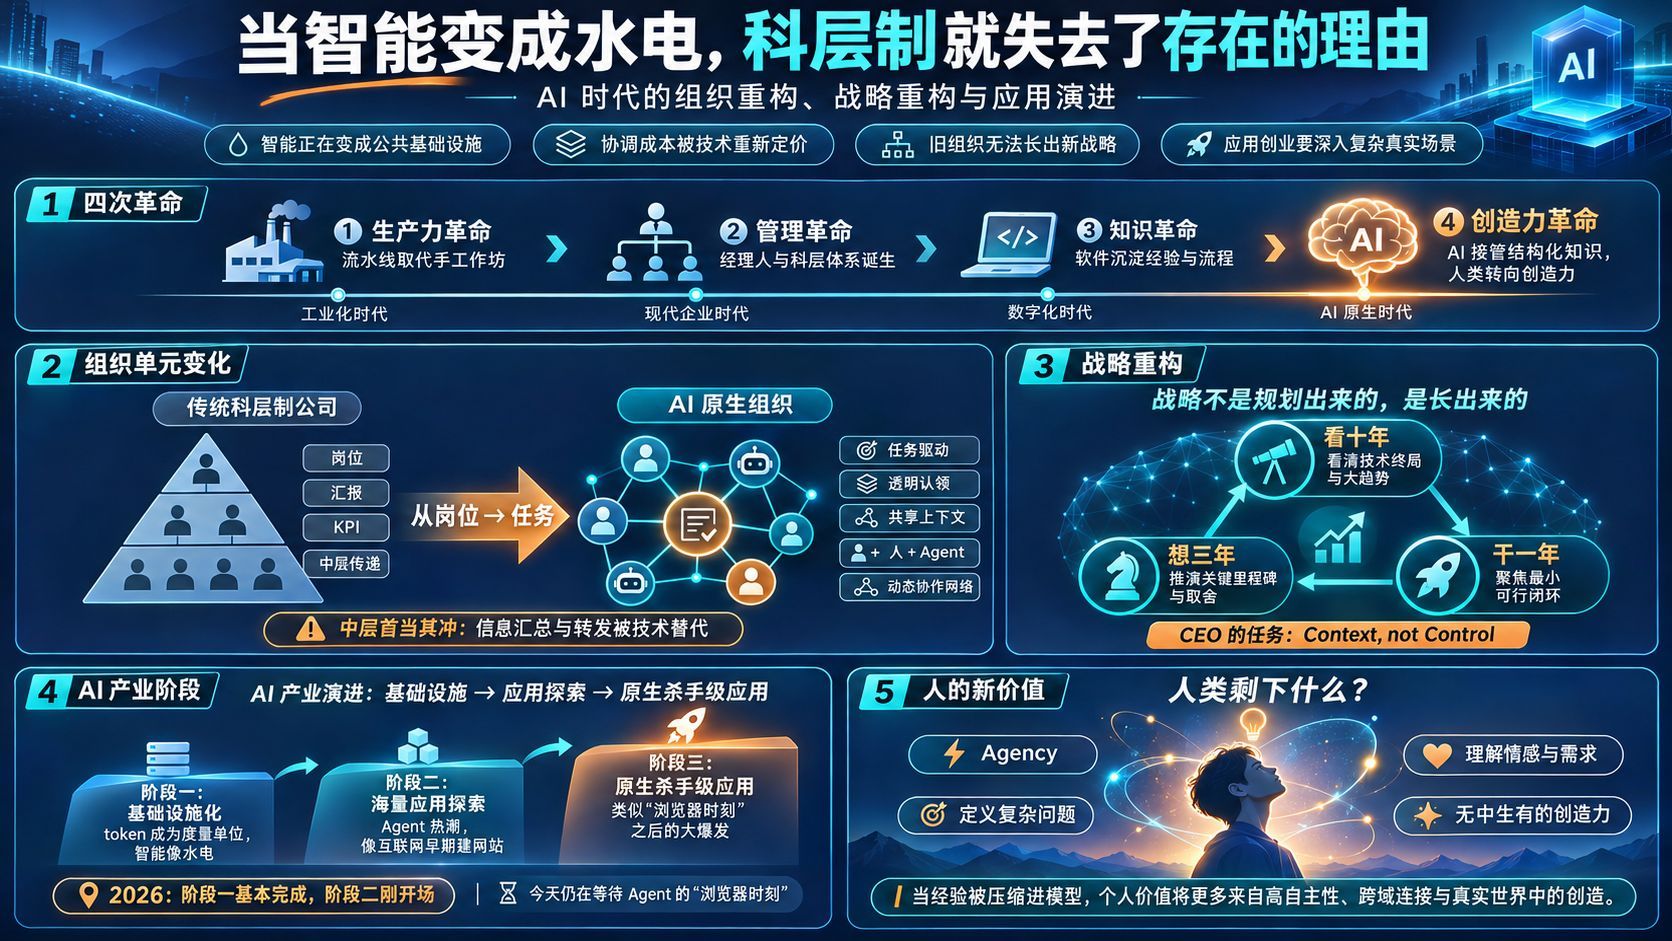
当智能变成水电,科层制就失去了存在的理由
曾鸣在新书《智能》中判断,工业时代的公司制度与科层制正在走向衰亡。当大模型把通用智能变成水电一样的基础设施,组织的最小单元从岗位转向任务,战略也从顶层规划变成组织自发生成。文章梳理 AI 产业的三阶段演进、token 成为度量衡后的云公司终局,以及应用层仍在等待自己的“浏览器时刻”,并追问知识被接管之后,人还剩下什么。

支持对已公开的 133 篇文章进行关键词模糊搜索、分类与标签筛选。
曾鸣在新书《智能》中判断,工业时代的公司制度与科层制正在走向衰亡。当大模型把通用智能变成水电一样的基础设施,组织的最小单元从岗位转向任务,战略也从顶层规划变成组织自发生成。文章梳理 AI 产业的三阶段演进、token 成为度量衡后的云公司终局,以及应用层仍在等待自己的“浏览器时刻”,并追问知识被接管之后,人还剩下什么。
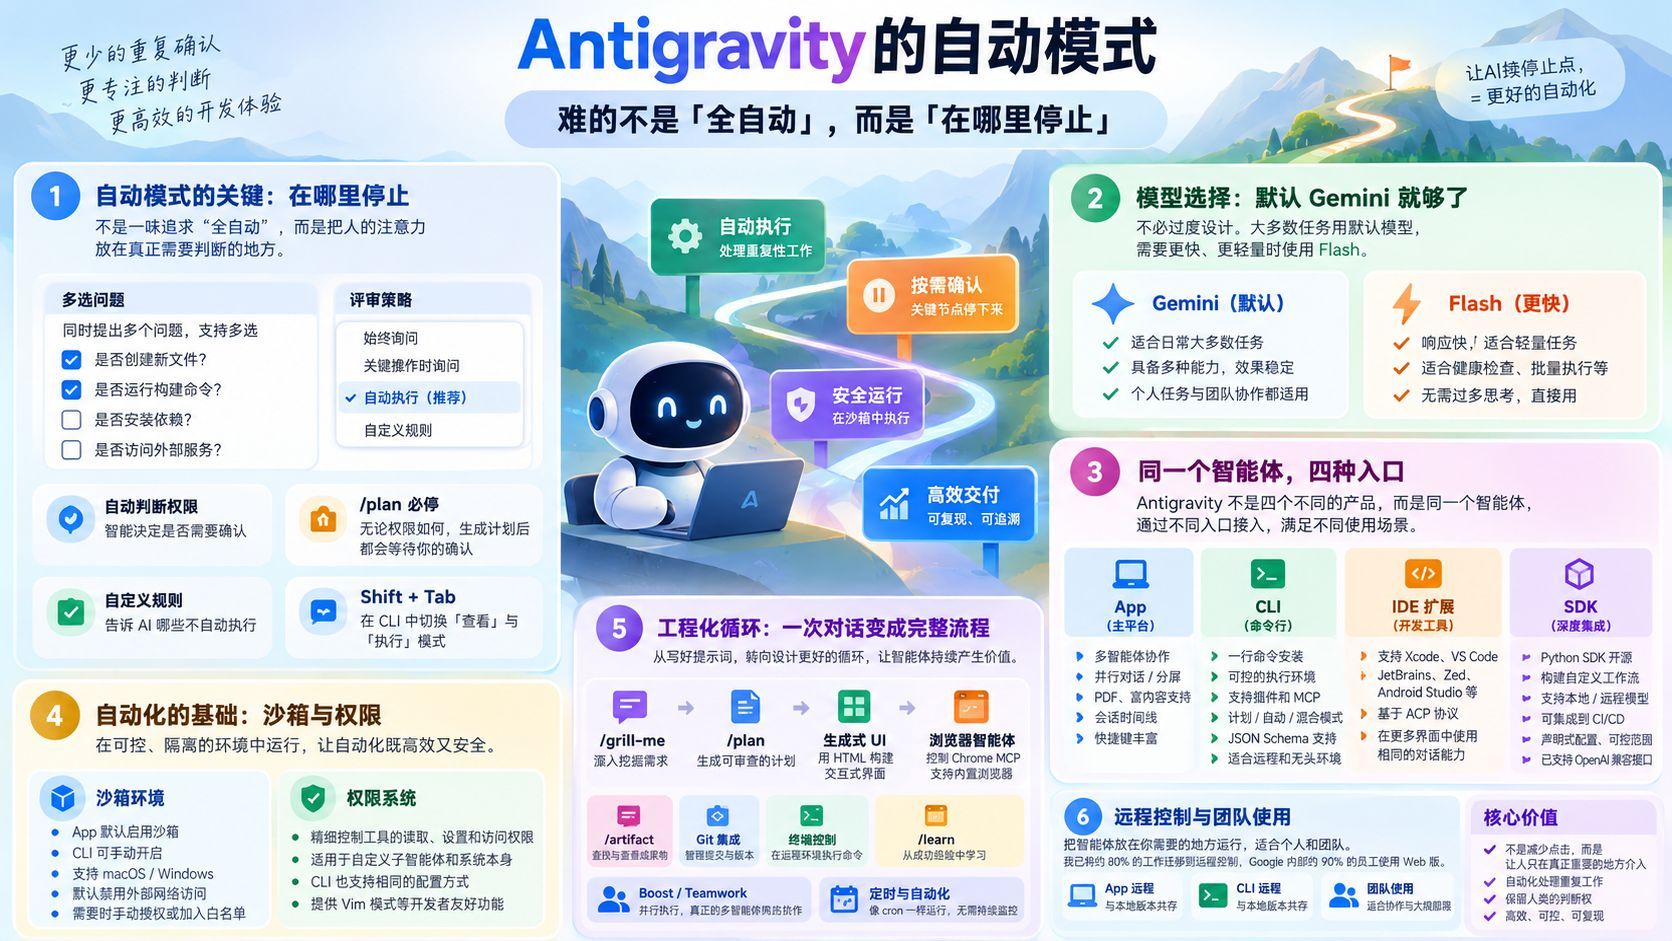
Google Antigravity 想做的不是更聪明的“全自动”,而是让人能设计“在哪里停”的分层控制。文章从多选提问、审核政策、自动权限、/plan 强制停顿、CLI 的 Shift-Tab 与规则设置讲起,再延伸到 App、CLI、IDE、SDK 四个入口,macOS/Windows 沙箱与权限系统,以及 Git 工作树、/learn 和日程自动化,结合现场演示与问答,解释自动模式怎样才能既快又不失控。
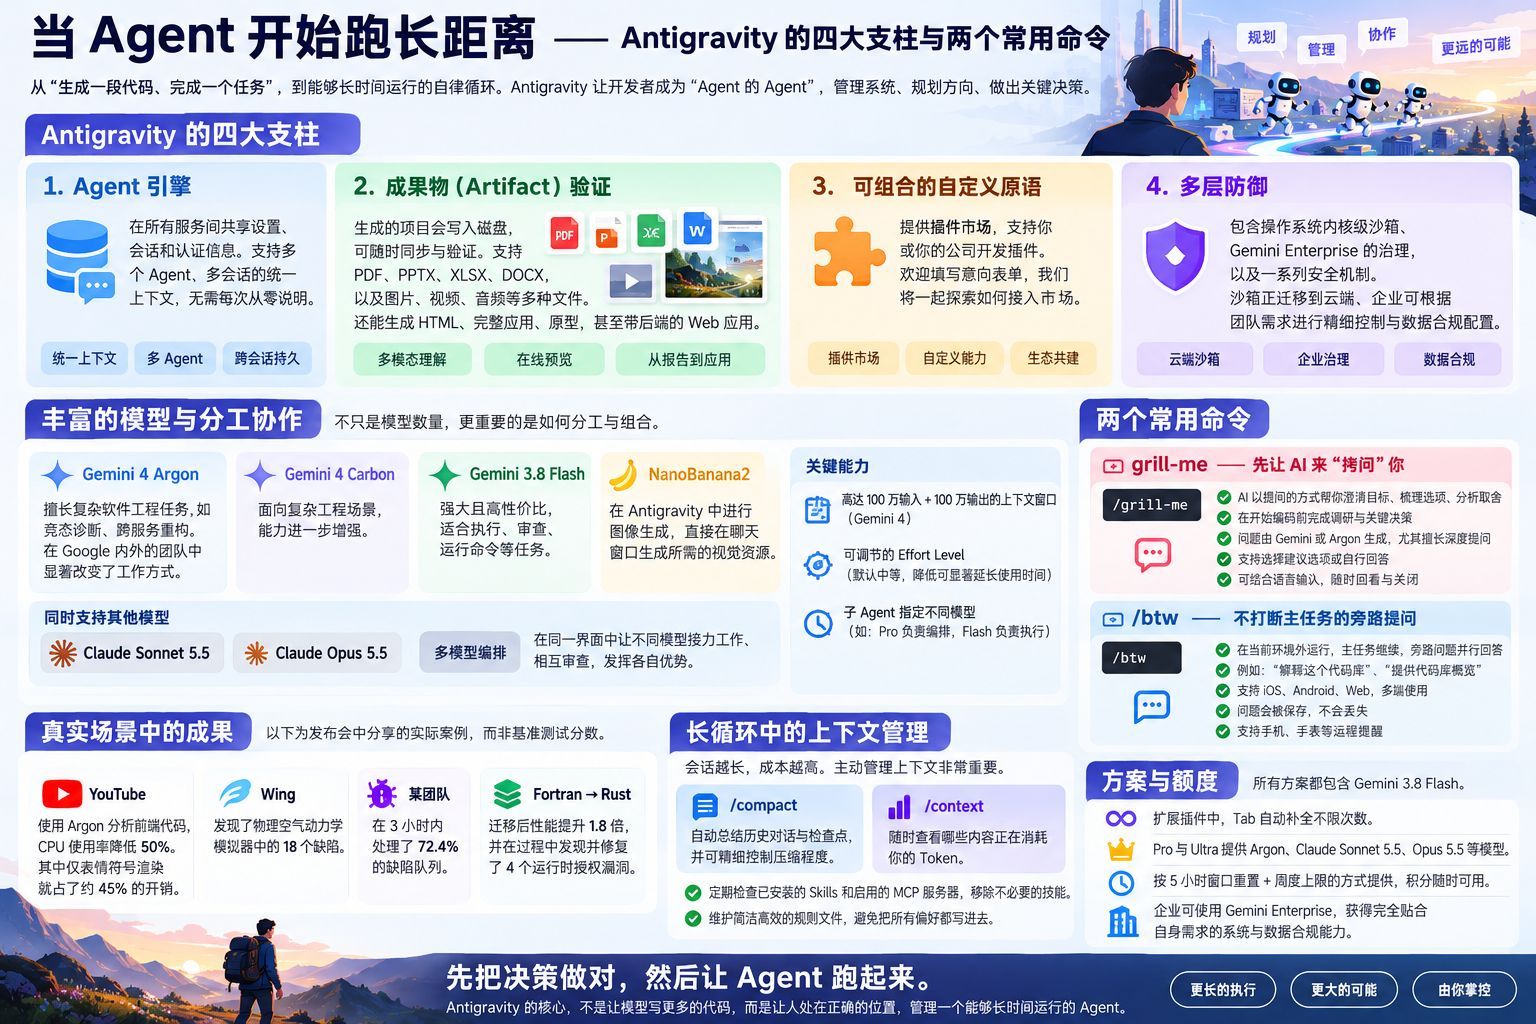
Antigravity 正从生成代码转向管理长时间运行的自主体。本文梳理它的四根支柱——代理引擎、工件验证、可组合原语与纵深防御,并说明 Gemini 4 Argon 与 3.8 Flash 如何分工、生产案例给出哪些数字,以及如何用 /compact、/context 管理上下文。最后介绍我最常用的 grill-me 和 /btw 两个命令。
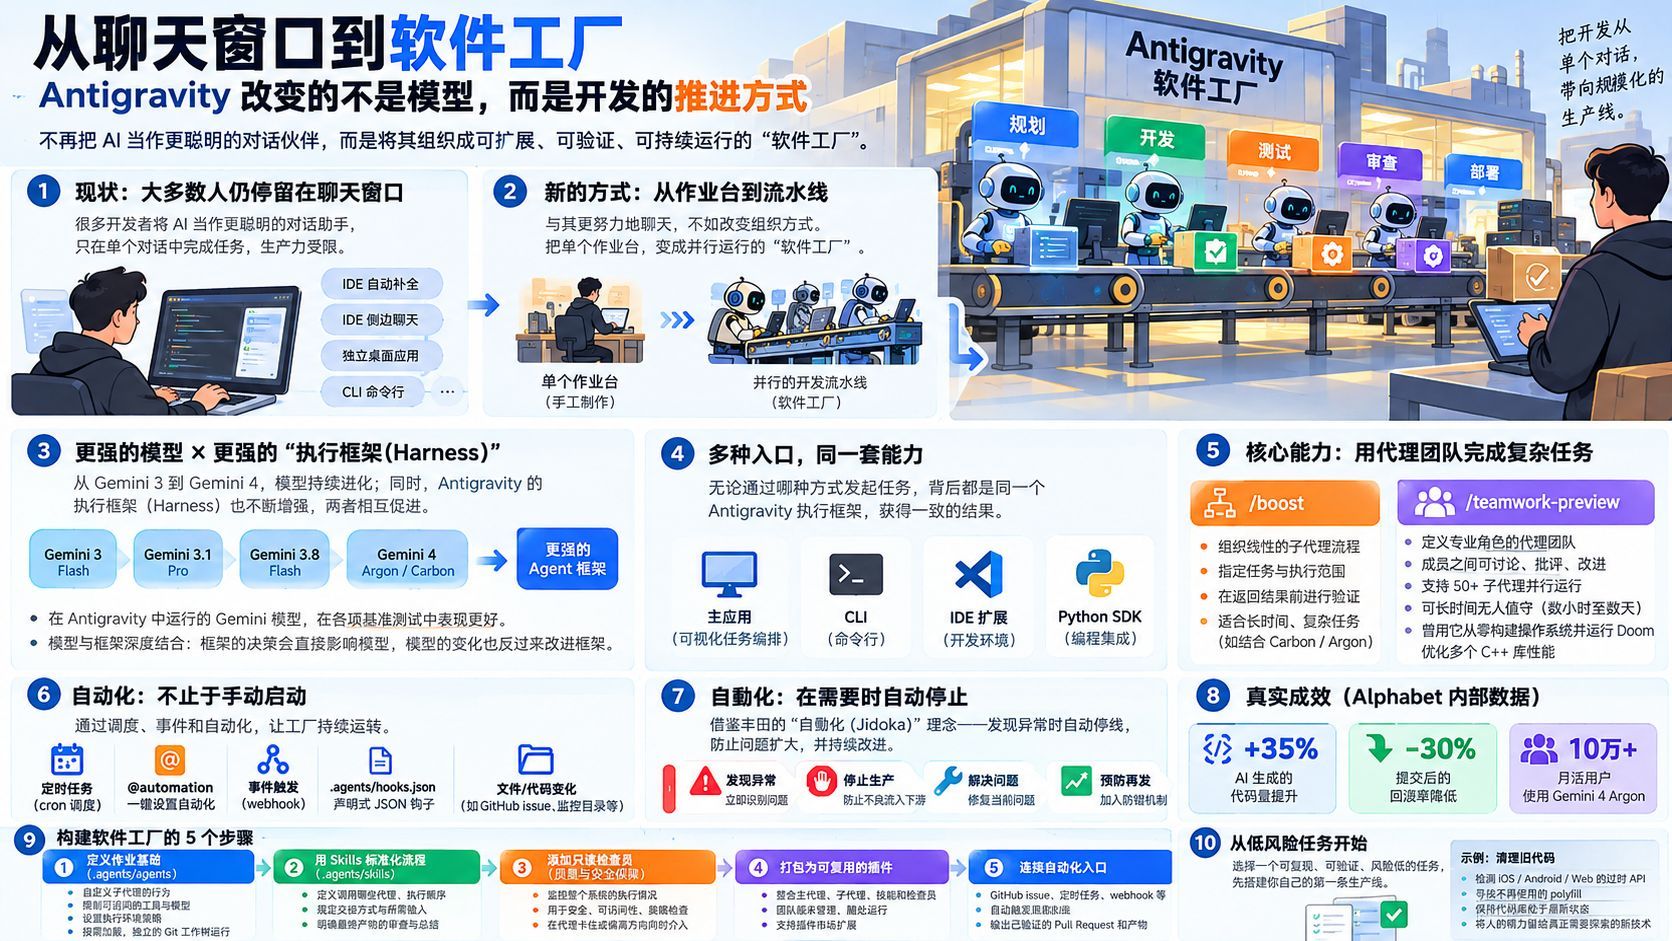
在 Antigravity 的 deep dive 上,Google 的资深开发者关系工程师提出:AI 编程不应停留在“更聪明的聊天对象”,而应把开发组织成并行装配线式的“软件工厂”。文章梳理模型与 harness 的共同进化、/boost 与 Teamwork Preview 的结构化委派、cron 与钩子触发的自动化、源自丰田自働化的停线与验证机制、.gemini/brain 的状态持久化,以及搭建产线的五个步骤。
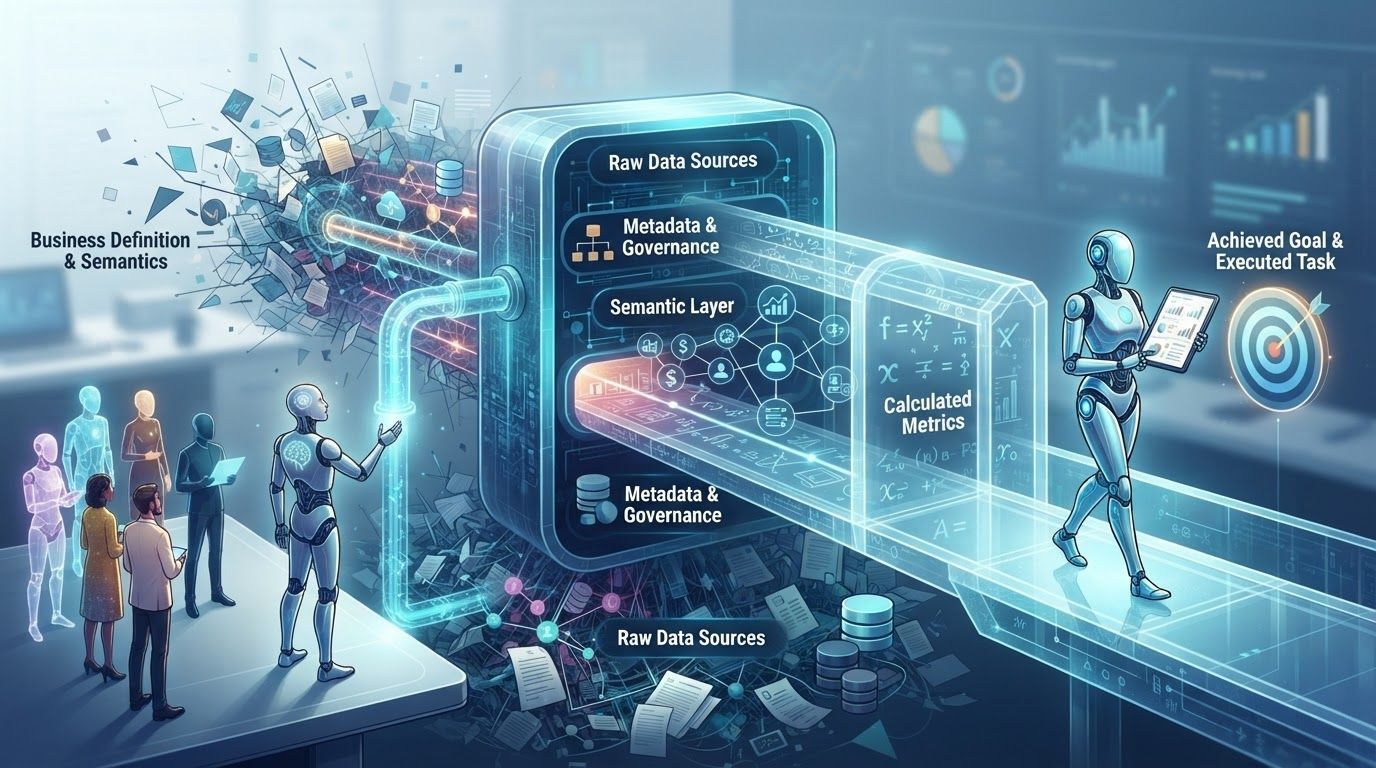
生成式 AI 正从「输入问题、返回答案」走向「给出目标、代理自主执行」。本文整理 Google Cloud 讲者关于 Agent 落地的判断:很多幻觉不是模型问题,而是业务定义没有写进上下文;PoC 规模一放大就会遇到成本、延迟、治理与复现性问题;解法是用数据源、元数据、语义层和计算口径搭起上下文架构,并用五类问题各 20 次的对比实验与银行、营销演示说明效果。
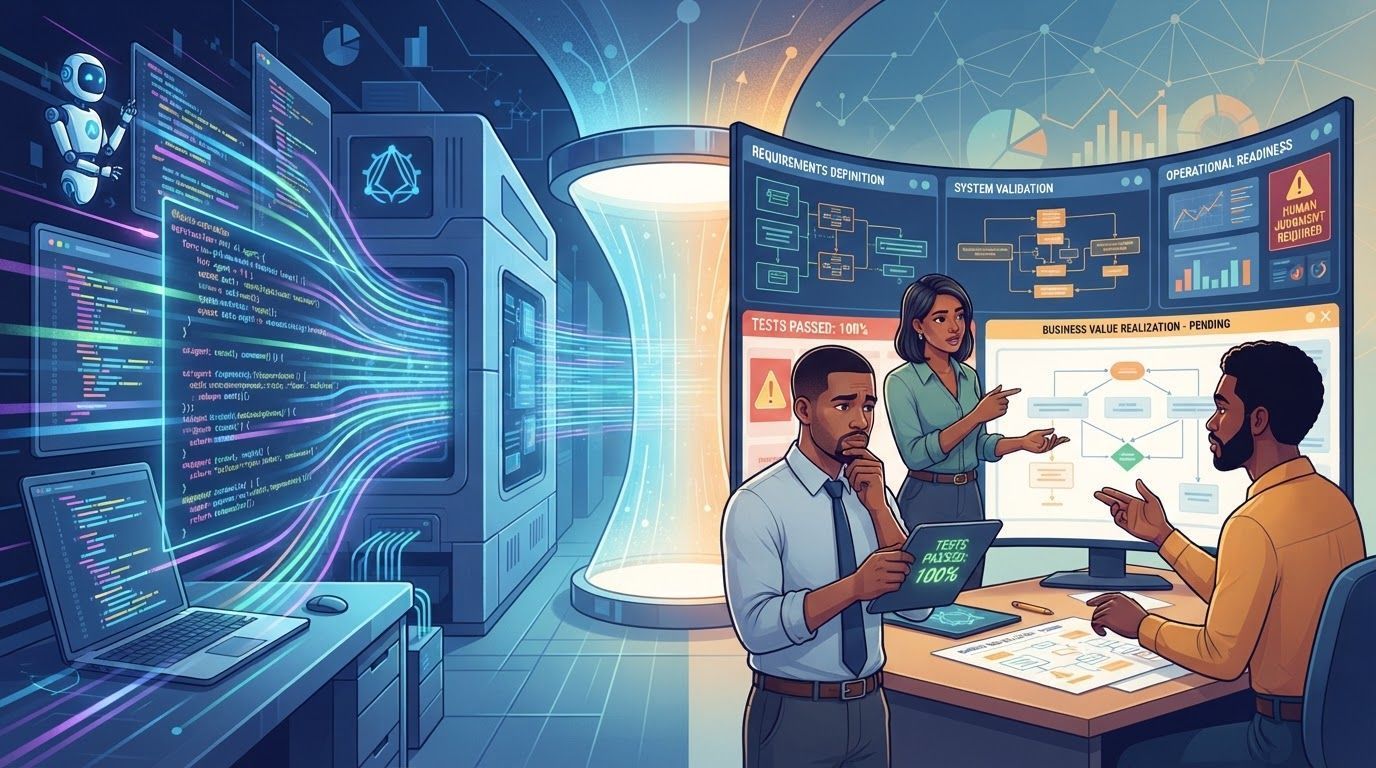
当 AI 让写代码变快,瓶颈并没有消失,而是移向需求定义、业务语言化与验证运营。测试全绿不等于产品正确,真正稀缺的是能连接客户、业务与工程的人。本文结合金融与通信场景,讨论 AI 的适用边界、人的判断,以及组织应从何处开始。
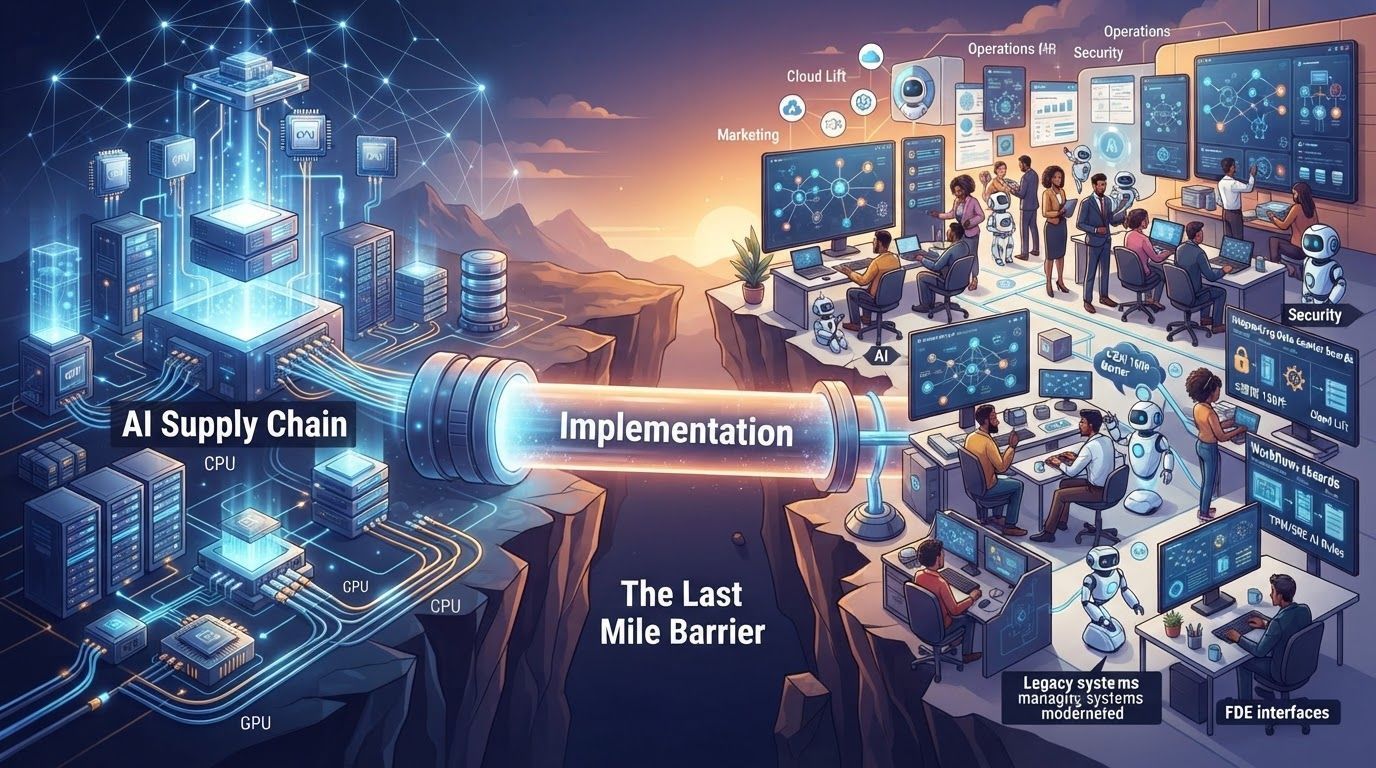
企业 AI 的成败不在模型,而在实装。SoftBank 的讲者把实装置于半导体、数据中心、电力与储能这条链的末端,谈到遍布各部门、彼此连携的 AI 代理,6 月发布的安全服务,FDE 的五级能力与最关键的系统设计判断力,以及大型机、COBOL 等遗留系统必须先做云迁移。六周约 150 个需求,一个人五到八小时走完,靠的是验证、实装、改善的循环。
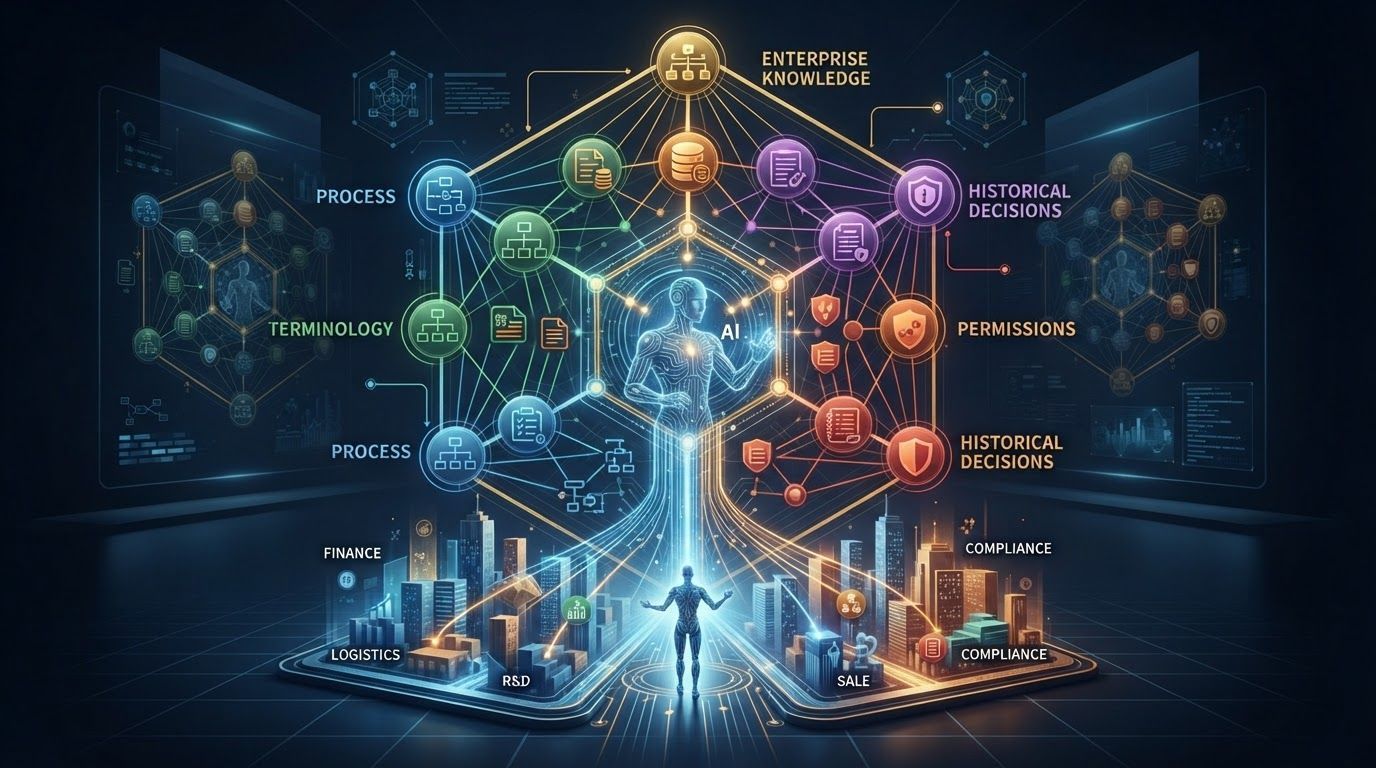
AI 智能体难以在企业中可靠行动,原因往往不是模型推理能力,而是缺少业务知识。Neo4j 发布的 Context Engine 用六层业务本体,把流程、术语、数据位置、权限与历史决策组织成一张图,并以 GraphRAG 检索和记忆学习支撑智能体。本文梳理其思路,也讨论 private preview 阶段仍需验证的问题。
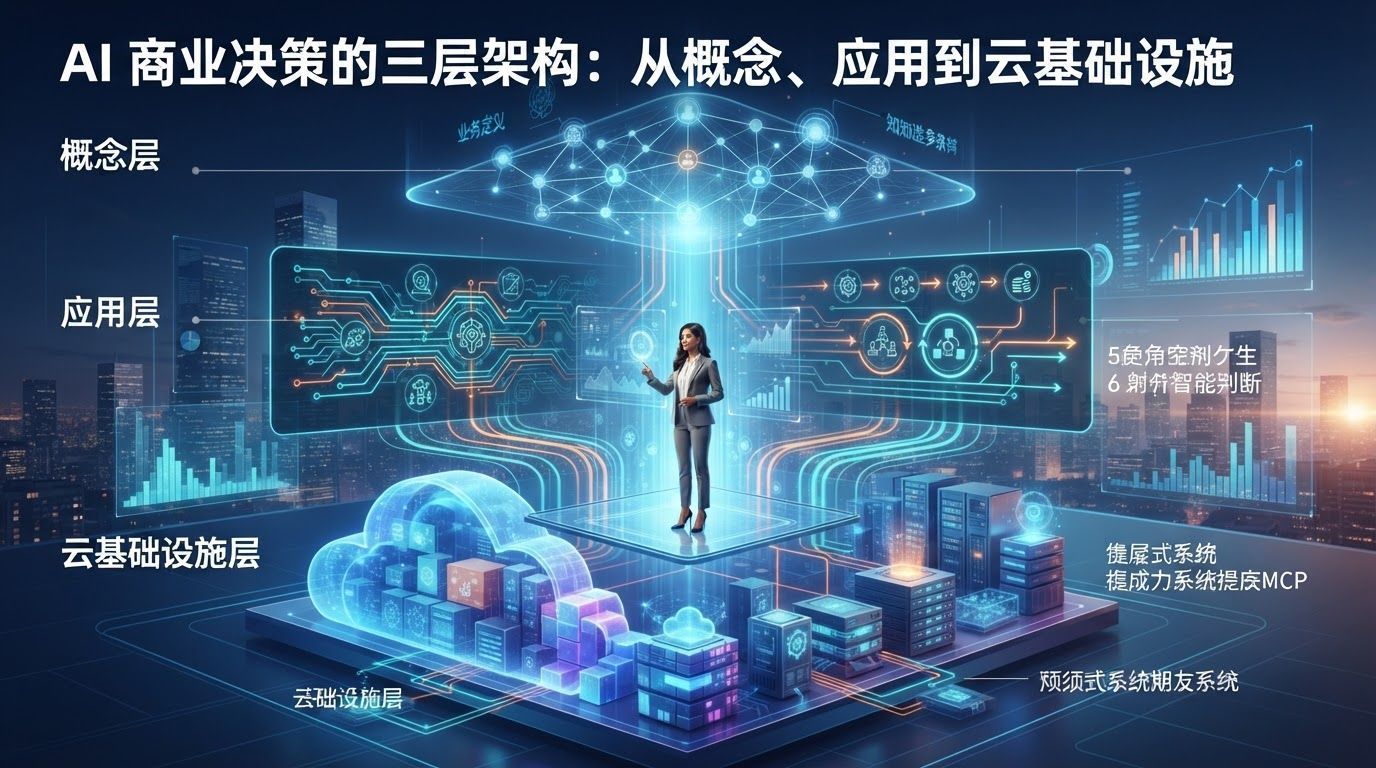
企业 AI 提案常常停在“需要知识图谱”的概念上。本文把它拆成三层:定义知识形态的概念层,抽取业务逻辑、让 AI 能判断的应用层,以及支撑判断与执行的云基础设施层。文章还讨论了由 5 个周期、6 种能力构成的判断框架,用 MCP 把旧系统包成 AI 可调用服务的 modernization 思路,以及为什么智能必须配得上执行。
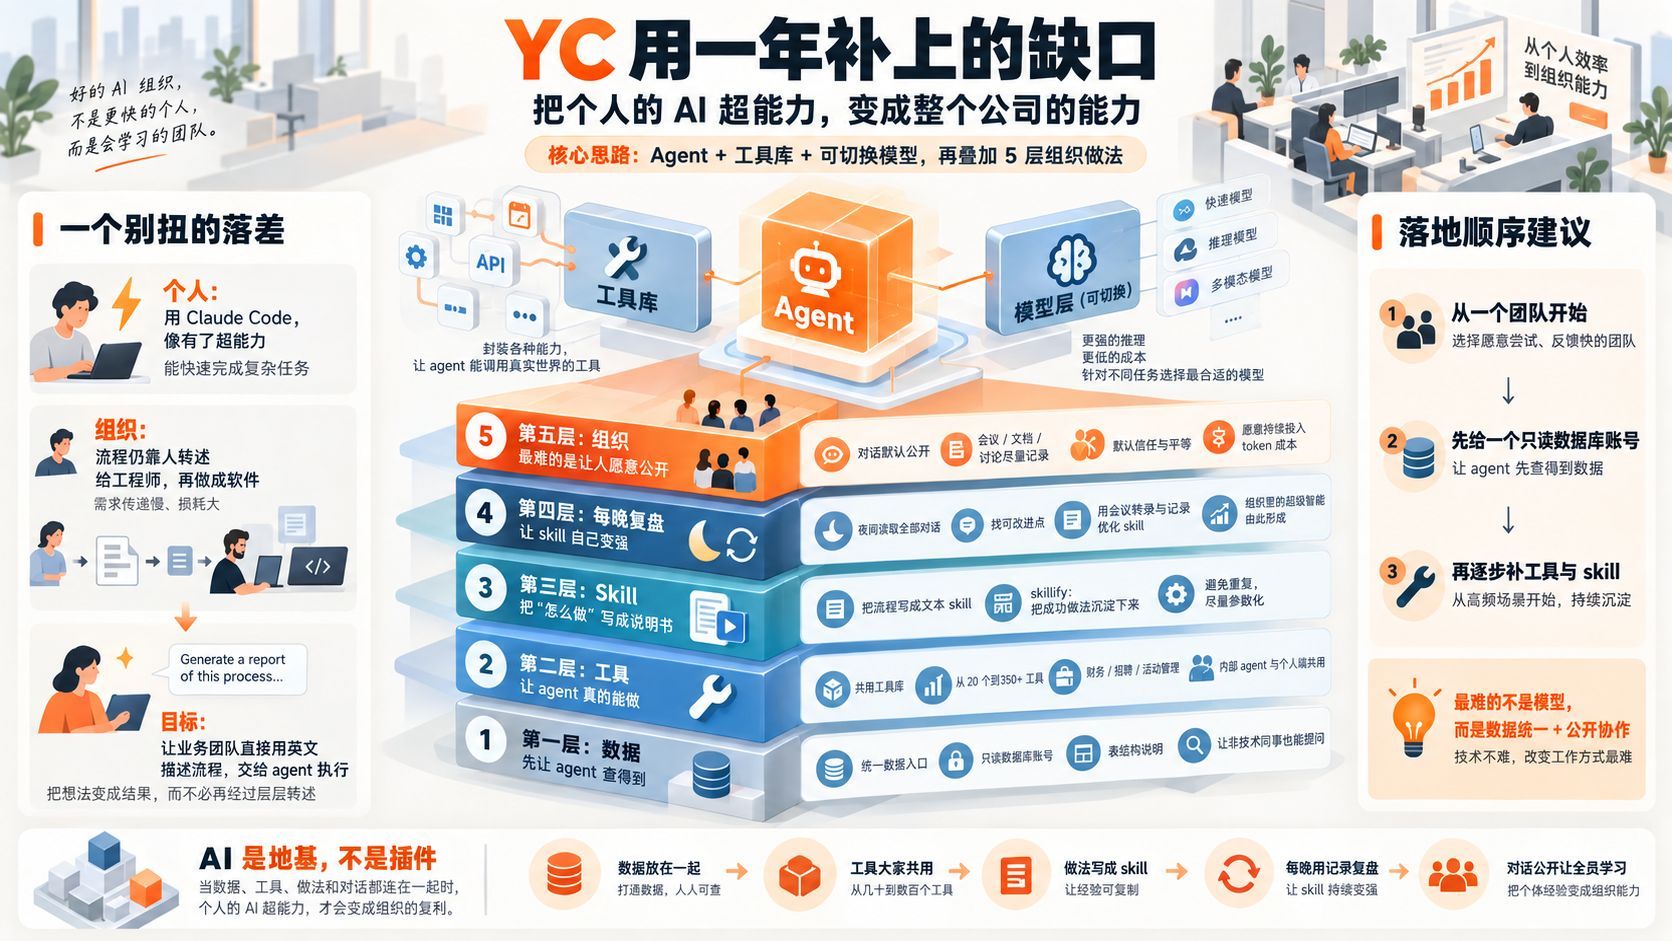
个人用 AI 已经很强,公司整体却没怎么变。YC 花一年搭起五层系统:统一数据、共用工具、把做法写成 skill、每晚用对话记录改进 skill,再把对话默认公开。合伙人 Pete 首次公开这套结构,本文按落地顺序拆解,并指出最难的两层与第一步。
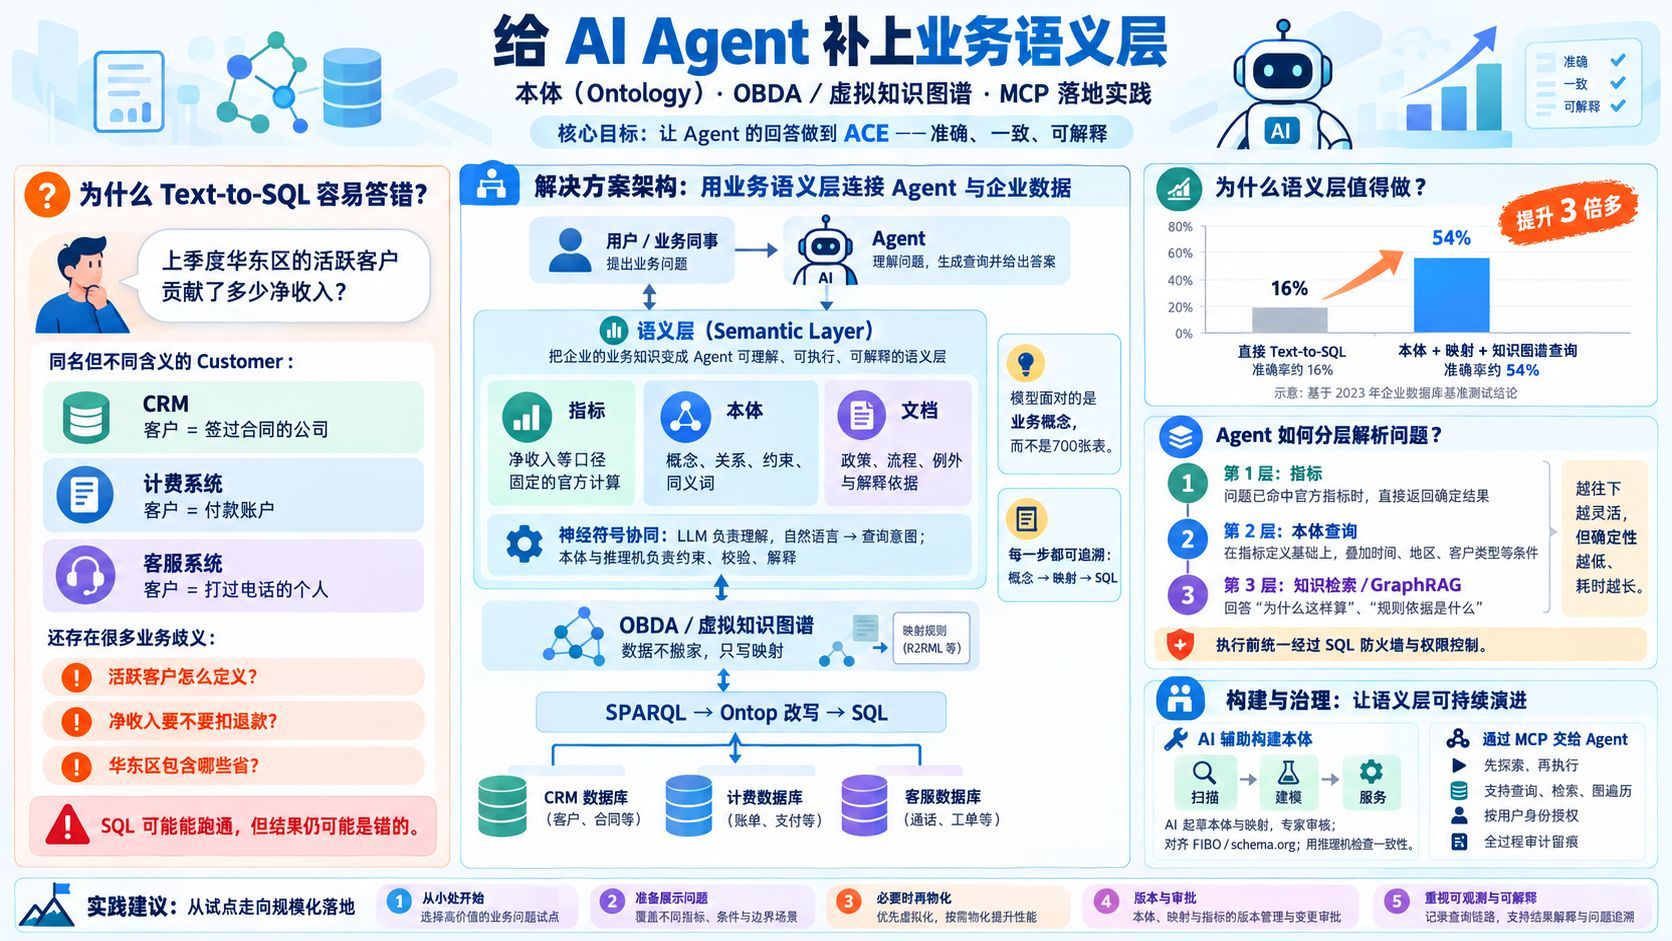
把表结构塞进提示词,并不能让 AI Agent 理解业务含义,它照样会给出看起来很专业、实际却算错的数字。本文以保险业基准测试中 GPT-4 执行准确率从约 16% 提升到约 54% 为例,讲清由指标、本体和文档组成的语义层,如何通过 OBDA(虚拟知识图谱)把本体直接映射到现有数据,并用分层解析兼顾确定性与灵活性。文章还介绍了用 AWS Context Ontology Accelerator 让 AI 起草本体、专家审核,以及 MCP 与身份感知的治理和五条实践建议。
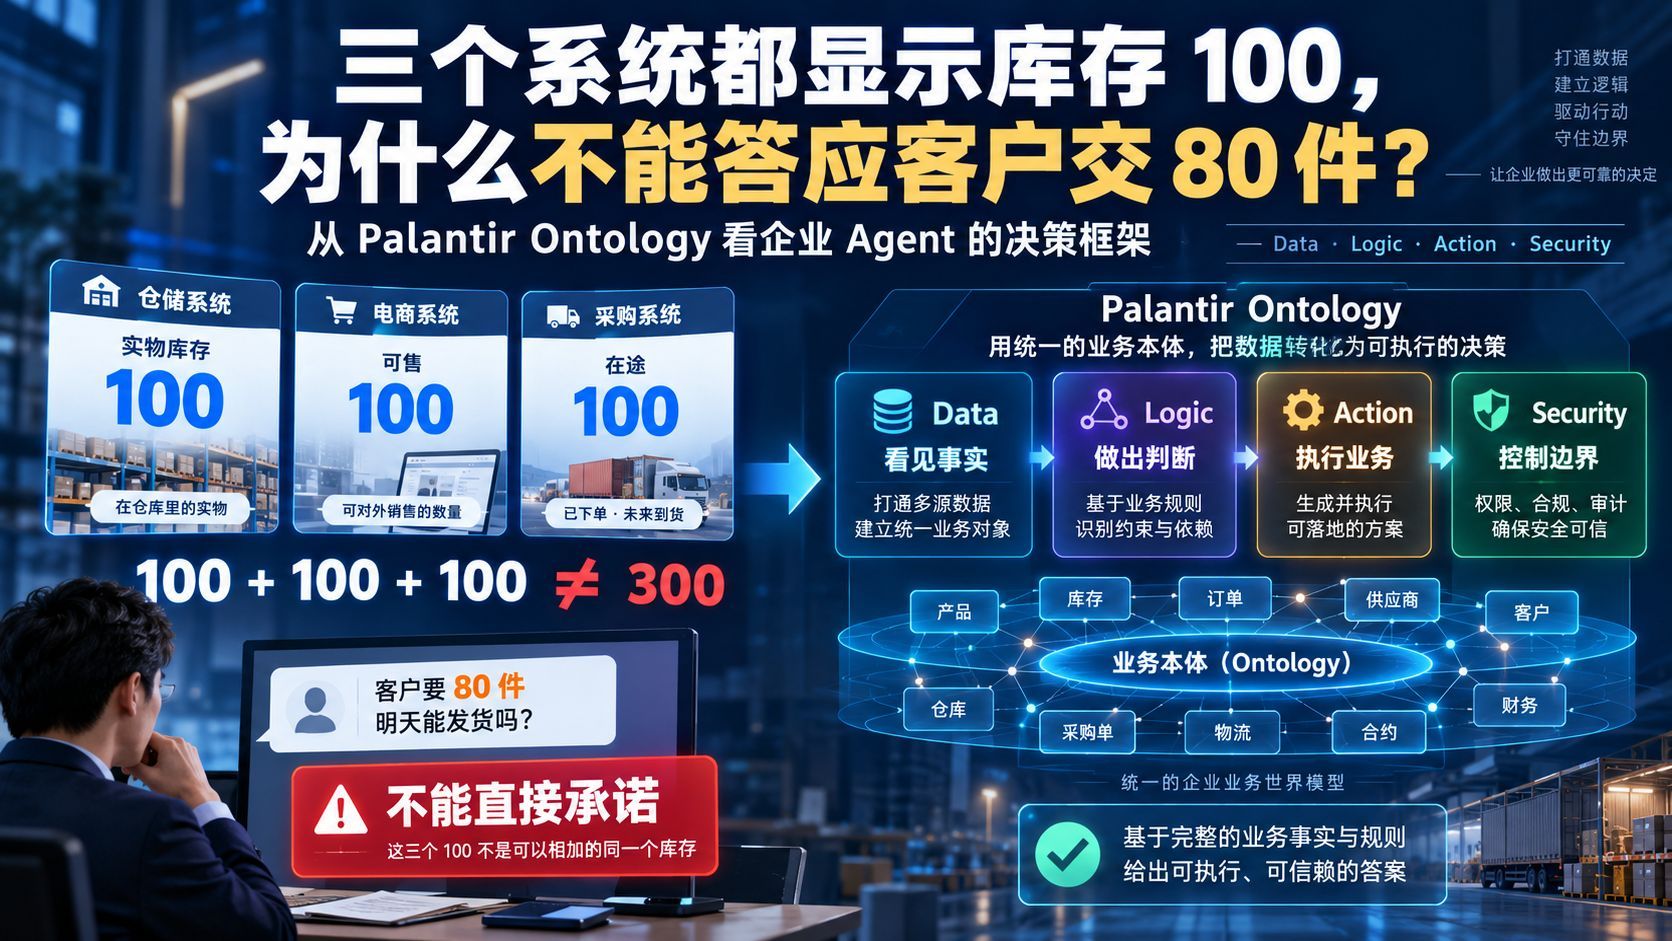
仓储、电商、采购三个系统各显示库存 100,加起来却不等于能交 300。Palantir 把真实业务决策拆成 Data、Logic、Action、Security 四部分,用 Object、Property、Link 描述业务世界,并让 AI 真正执行且受权限约束。本文用库存案例讲清 Ontology 的核心,并讨论大模型时代如何用 skills 与 MCP 复现这套理念:先做 Agent,再让 Ontology 随复杂度长出来。