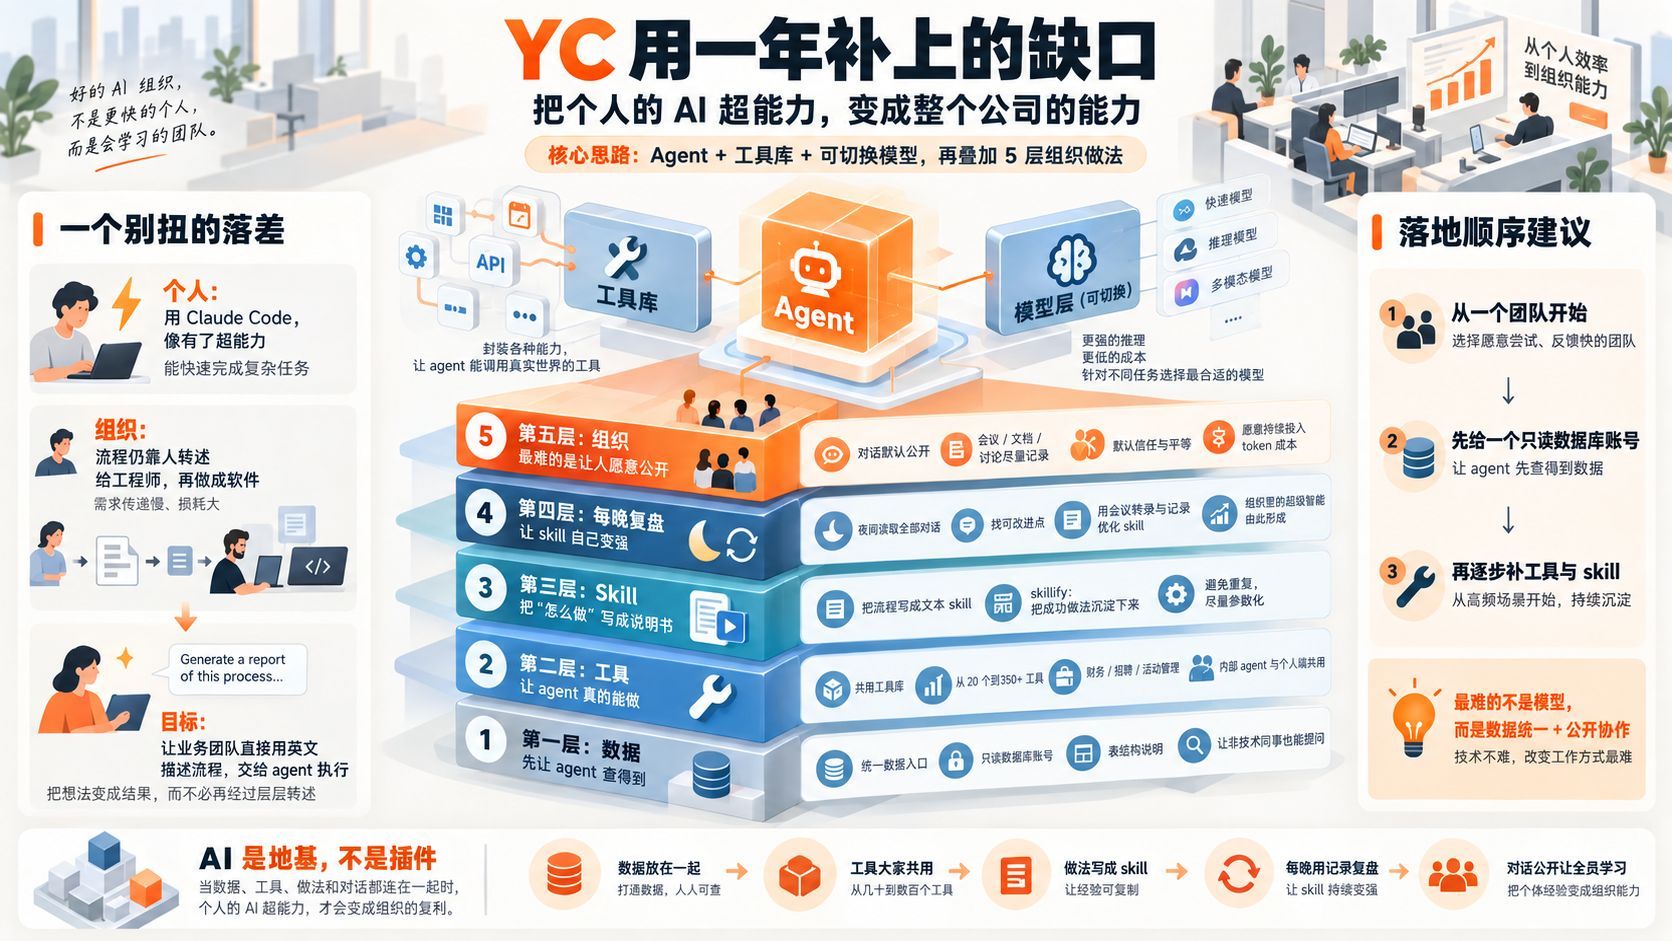
YC 用一年补上的缺口:把个人的 AI 超能力,变成整个公司的能力
个人用 AI 已经很强,公司整体却没怎么变。YC 花一年搭起五层系统:统一数据、共用工具、把做法写成 skill、每晚用对话记录改进 skill,再把对话默认公开。合伙人 Pete 首次公开这套结构,本文按落地顺序拆解,并指出最难的两层与第一步。

支持对已公开的 136 篇文章进行关键词模糊搜索、分类与标签筛选。
个人用 AI 已经很强,公司整体却没怎么变。YC 花一年搭起五层系统:统一数据、共用工具、把做法写成 skill、每晚用对话记录改进 skill,再把对话默认公开。合伙人 Pete 首次公开这套结构,本文按落地顺序拆解,并指出最难的两层与第一步。
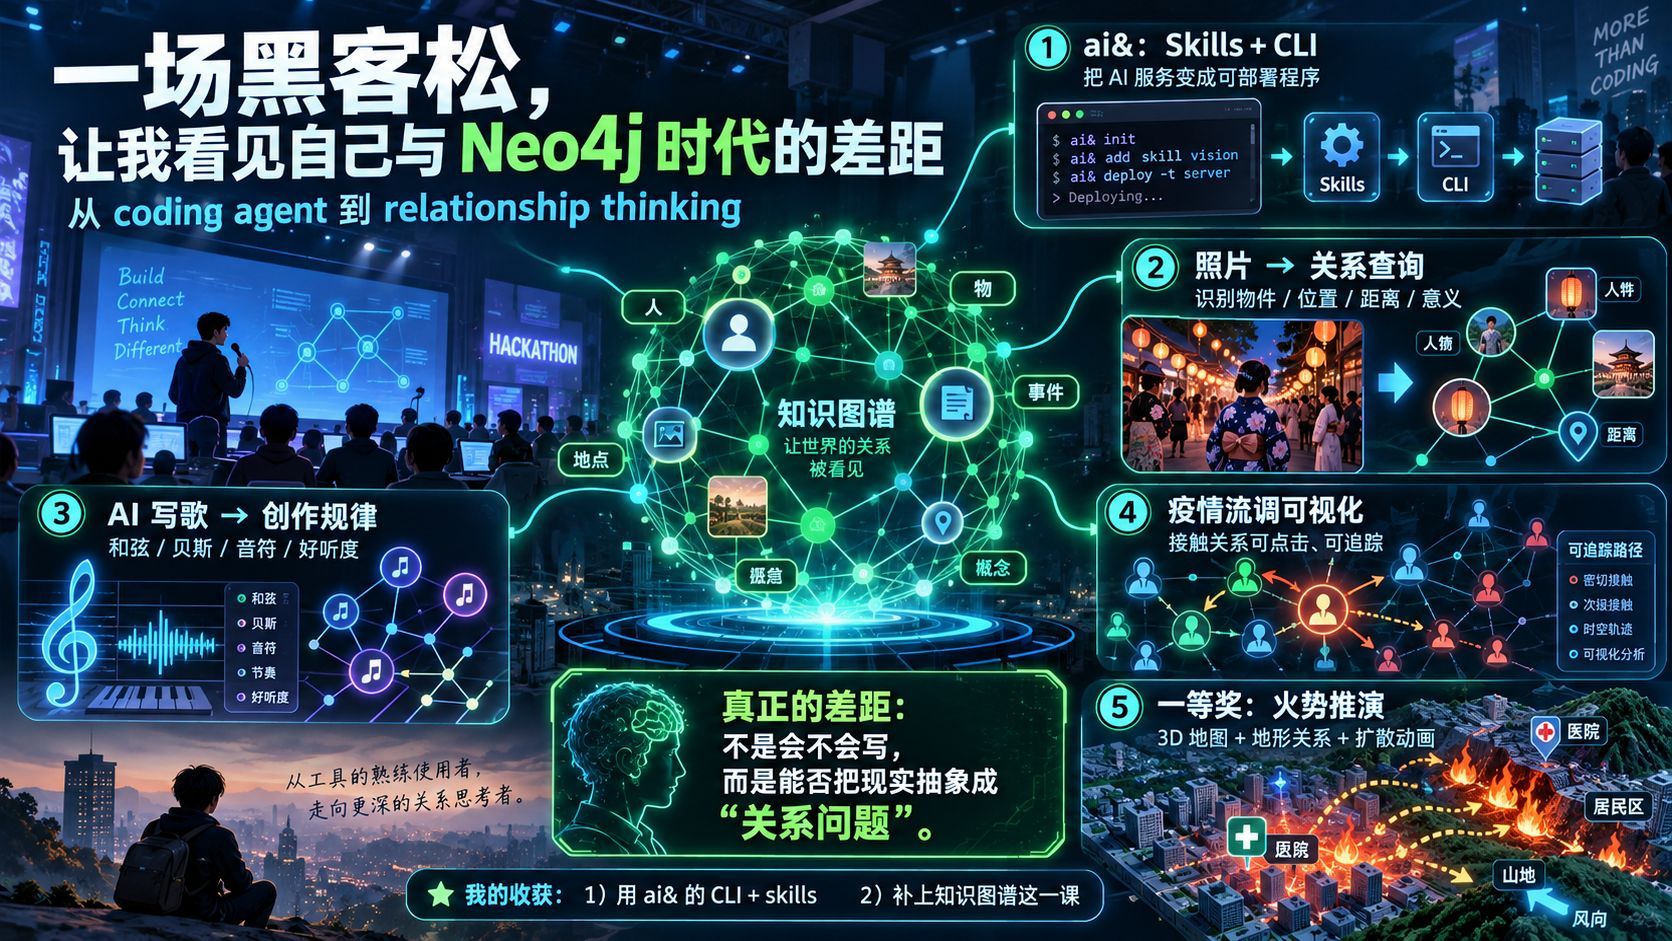
参加 +81 Builders 的黑客松,体验了 ai& 用 CLI 与 skills 把 AI 服务变成可部署服务器的做法,以及 MiniMax 视频生成的速度与低成本;更受冲击的是参赛者四小时内用 Neo4j 做出的照片关系解析、音乐分析、流调动态图谱与火灾推演。作者由此感到,仅靠 coding agent 的熟练已不够,开始补课知识图谱。
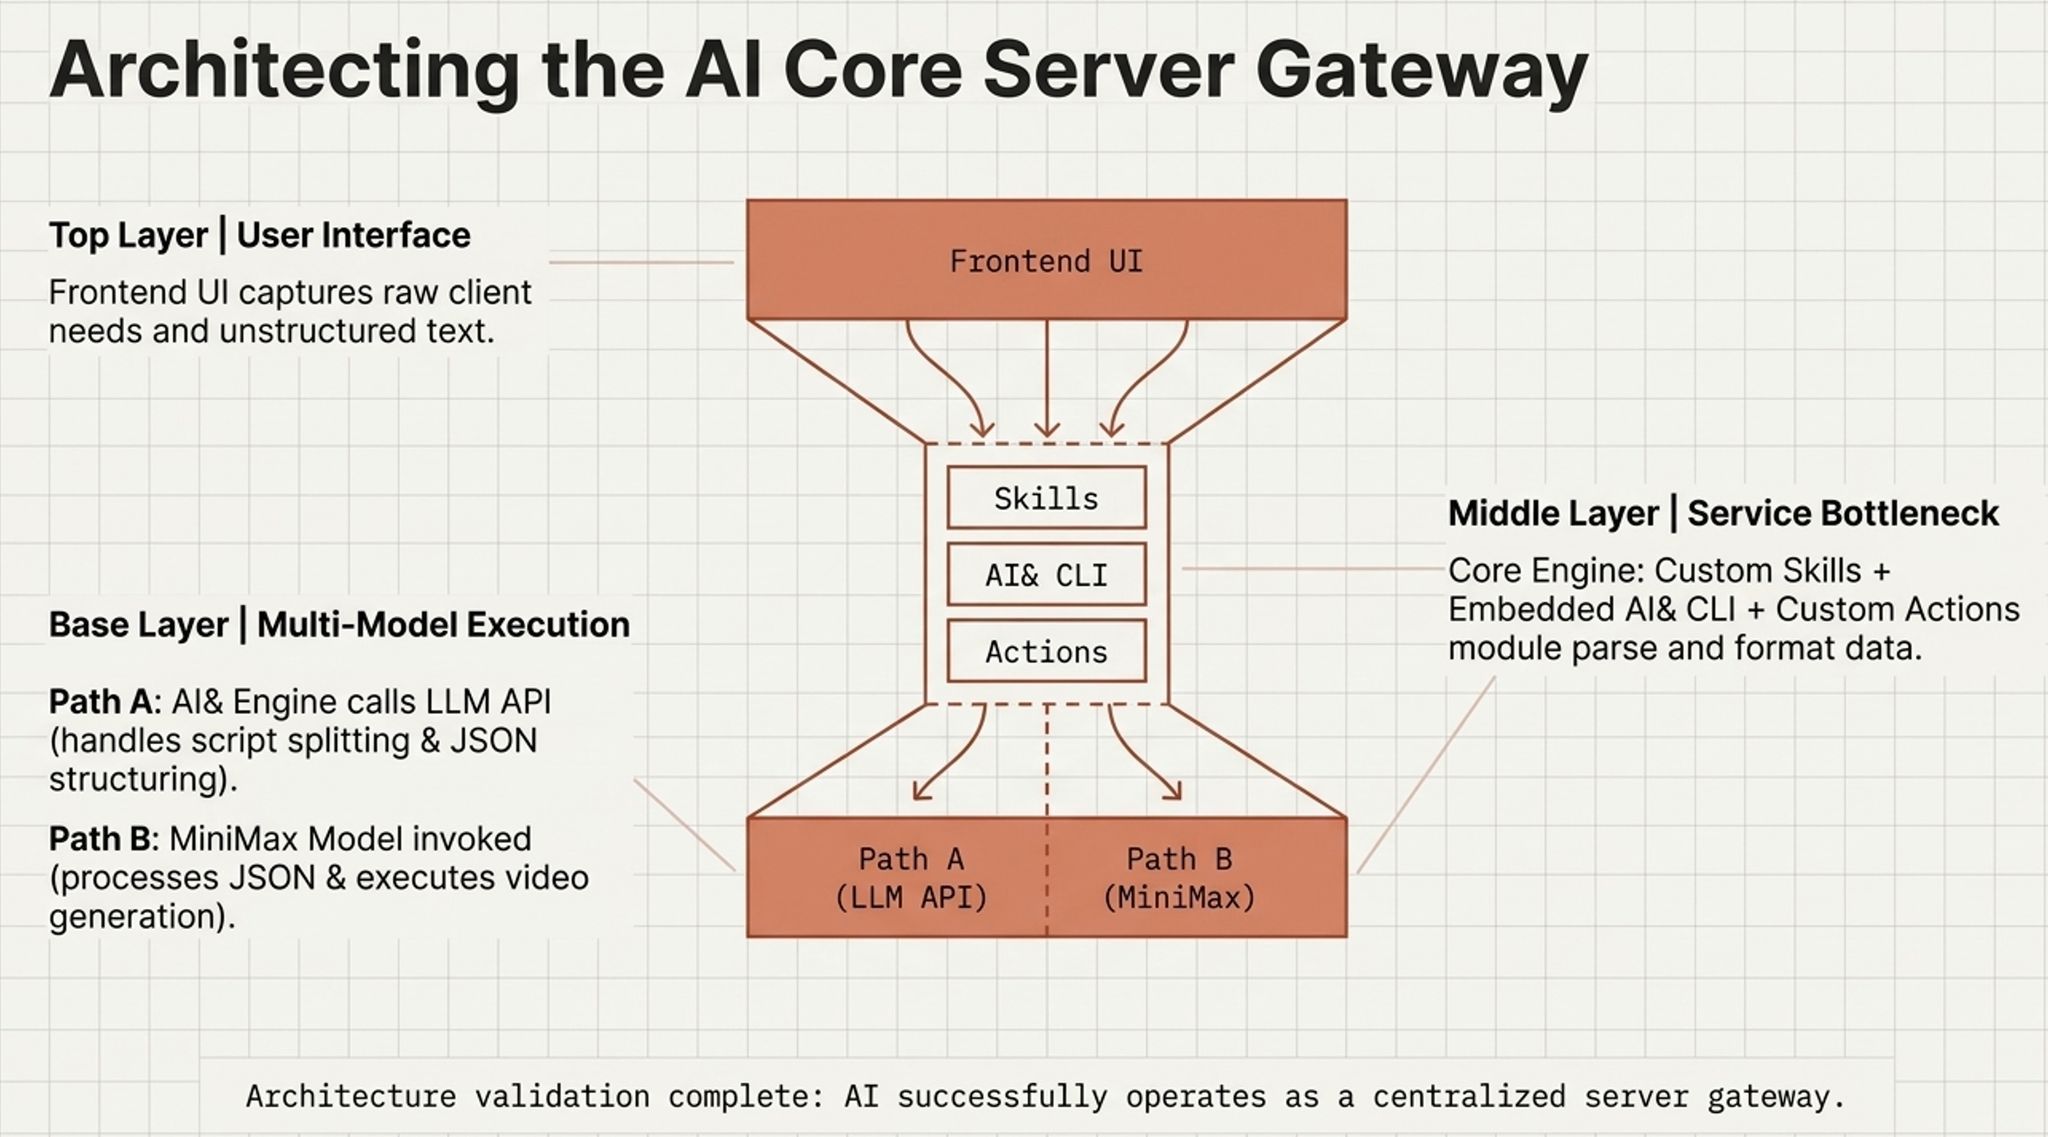
这次黑客松我开发了一套从故事或博客生成视频的工具,并完成了三层验证。第一层把故事自动拆成多节,生成提示词、角色与配音,再逐节生成视频;第二层把 AI& CLI 包装成服务层,用 skills 驱动 AI LLM API,让非程序员也能使用;第三层先写好配音,再以配音为参考让 MiniMax 生成画面,形成声音驱动的视频生成方法。三个验证都成功了。
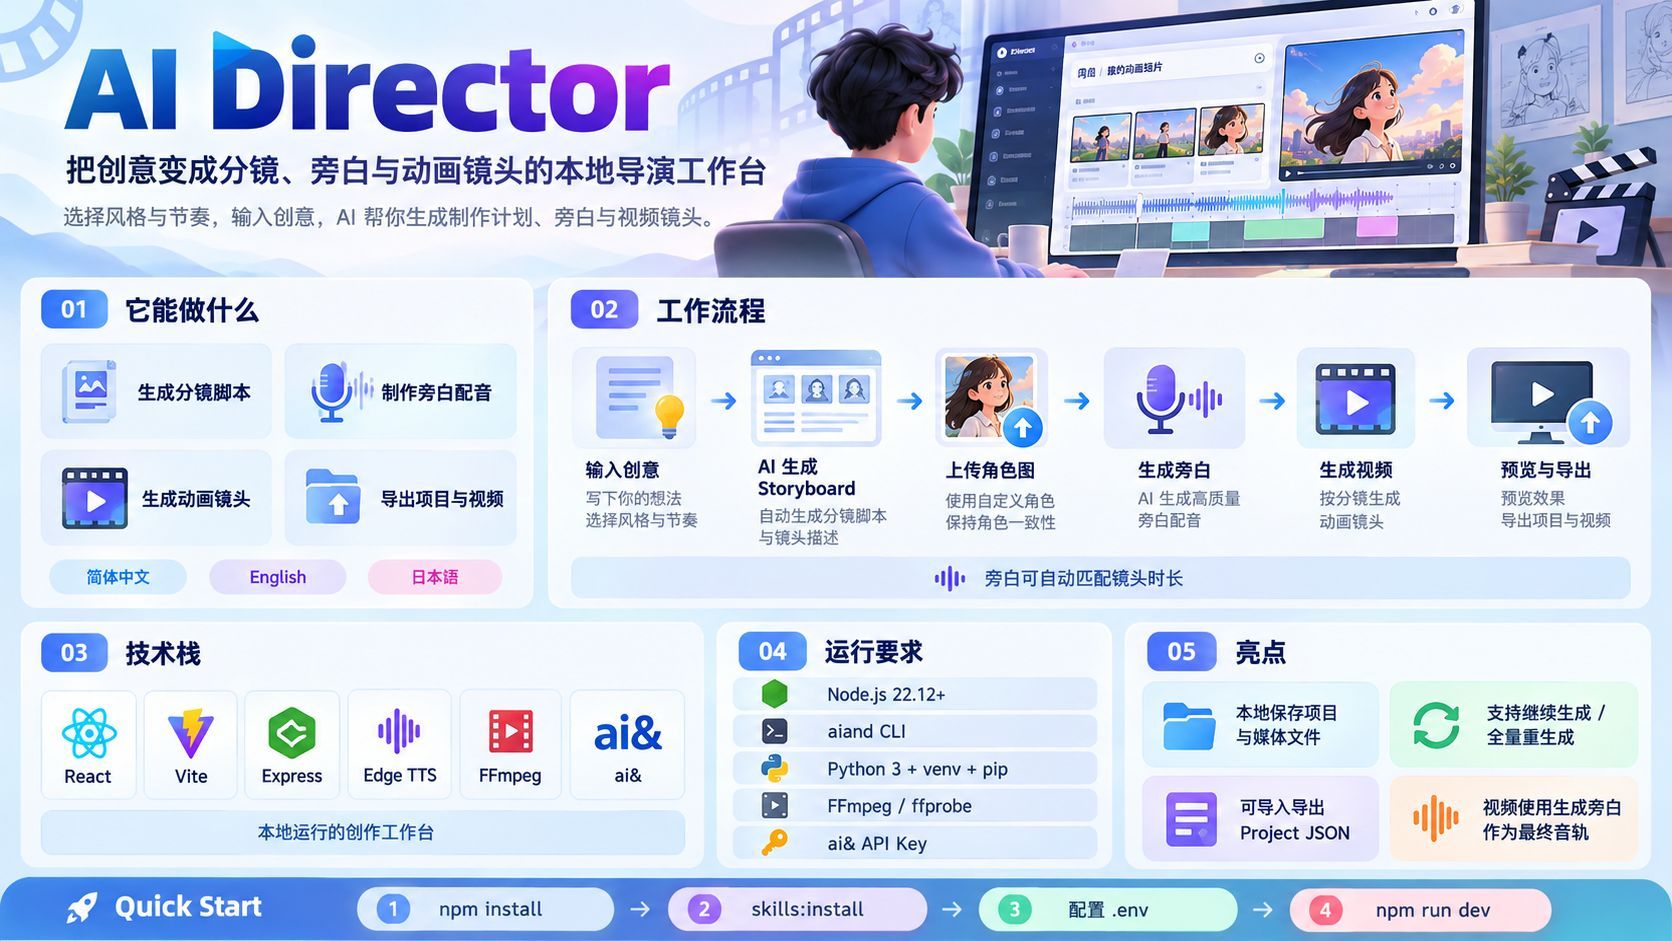
AI Director 是一个跑在本地的导演工作台,把想法拆成分镜、角色、配音和镜头。它用通过校验的项目 JSON 约束 AI 输出,以 Edge TTS 生成旁白并按镜头时长调整语速,再通过 ai& 的 MiniMax H3 生成视频。本文梳理它的制作流程、时间轴处理、付费任务的边界、本地优先的数据设计,以及显式加载并校验 Skill 的工程取舍。
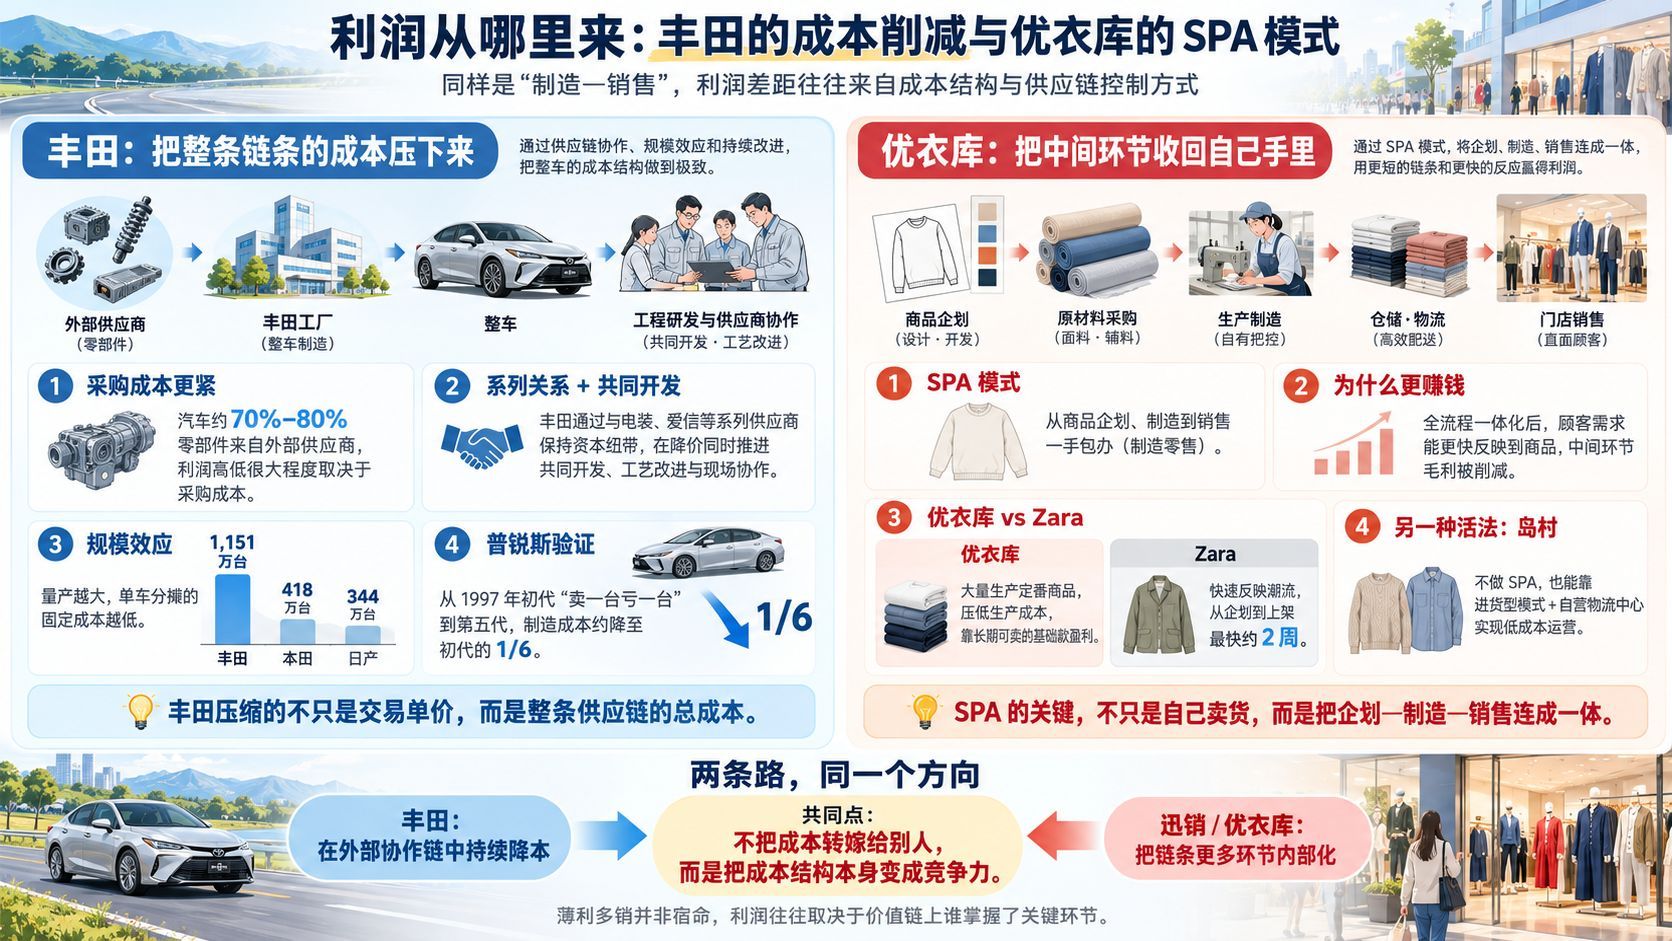
同样采用制造销售模式,丰田的利润率却高于本田和日产。这背后既有与电装、爱信等有资本纽带的系列零部件厂商协作、彻底削减成本的做法,也有 2023 年全球产量 1,151 万台的量产效应。另一个案例是靠 SPA 模式知名的迅销(优衣库):它把企划、制造与销售一手包办,削减中间环节的毛利,并以与 Zara 正相反的定番商品策略成为全球企业。本文从「如何把成本结构变成竞争力」的角度,比较汽车与服装两个行业。
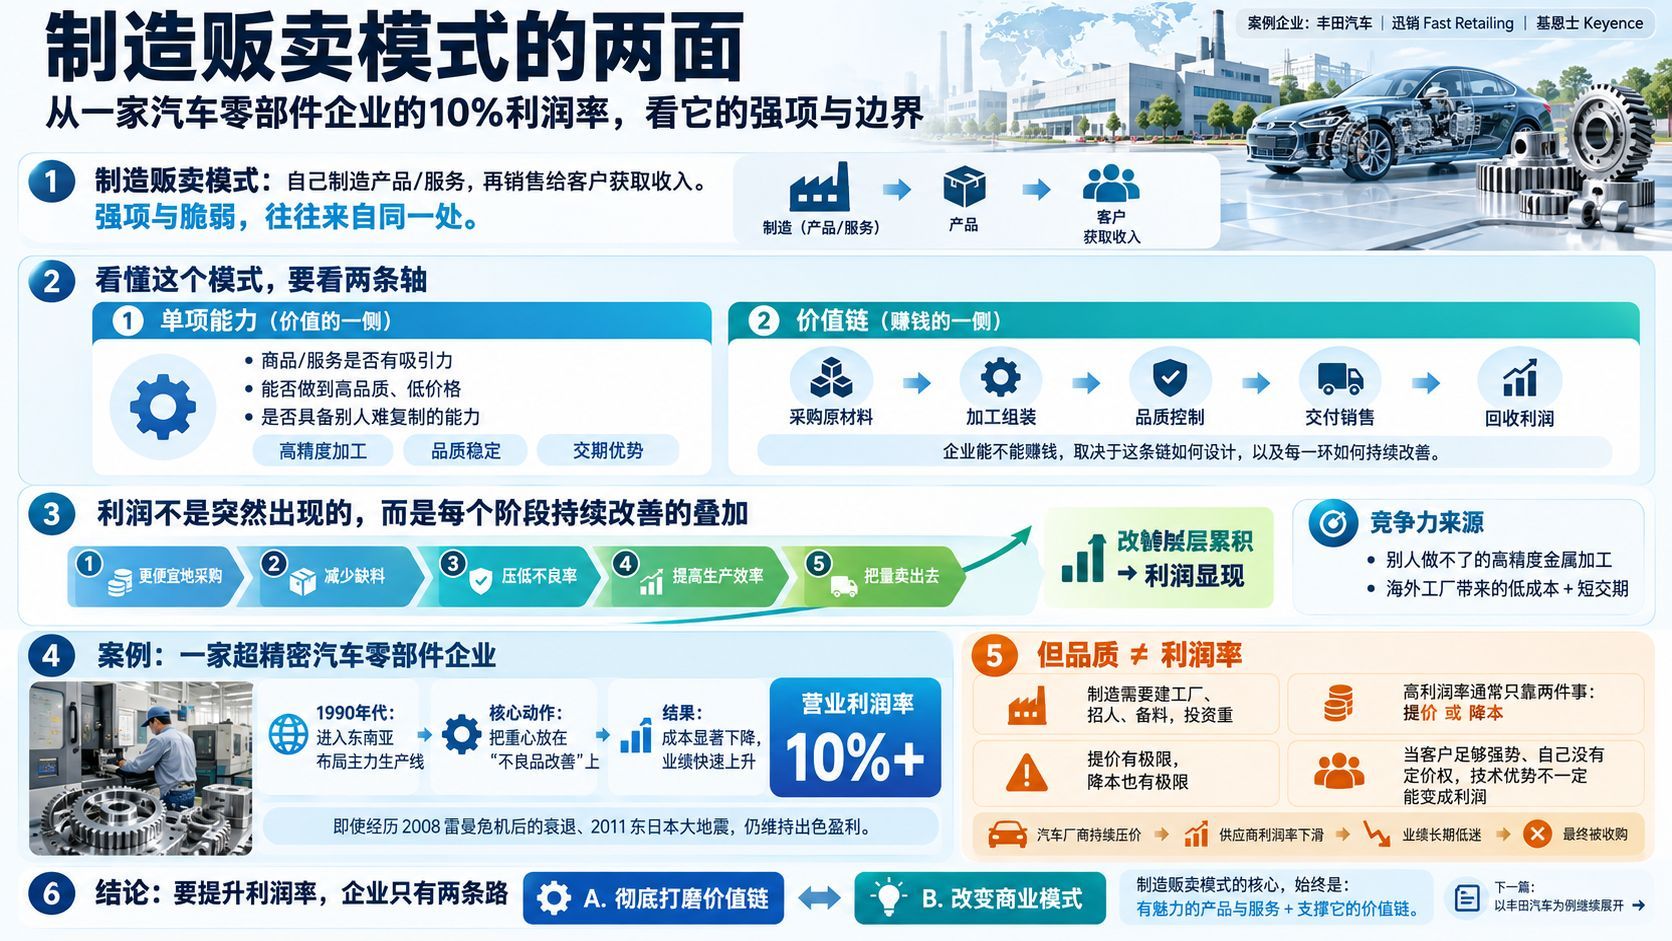
制造贩卖模式看似简单:企业自己制造并销售产品、从客户获得对价,但它的强项与脆弱来自同一处。关键在两条轴——做高品质、低价格、别人做不到的“单项能力”,和在价值链里采购、加工、交付的收入方式。案例中,一家超精密零部件企业因量产不良品长期停滞,1990年代转往东南亚并彻底改善不良,最终在雷曼危机与东日本大地震中仍做到10%出头的营业利润率。但品质和利润率是两回事:无法拒绝客户降价要求的企业业绩难恢复,最终被收购。出路只有彻底打磨价值链,或改变模式本身。
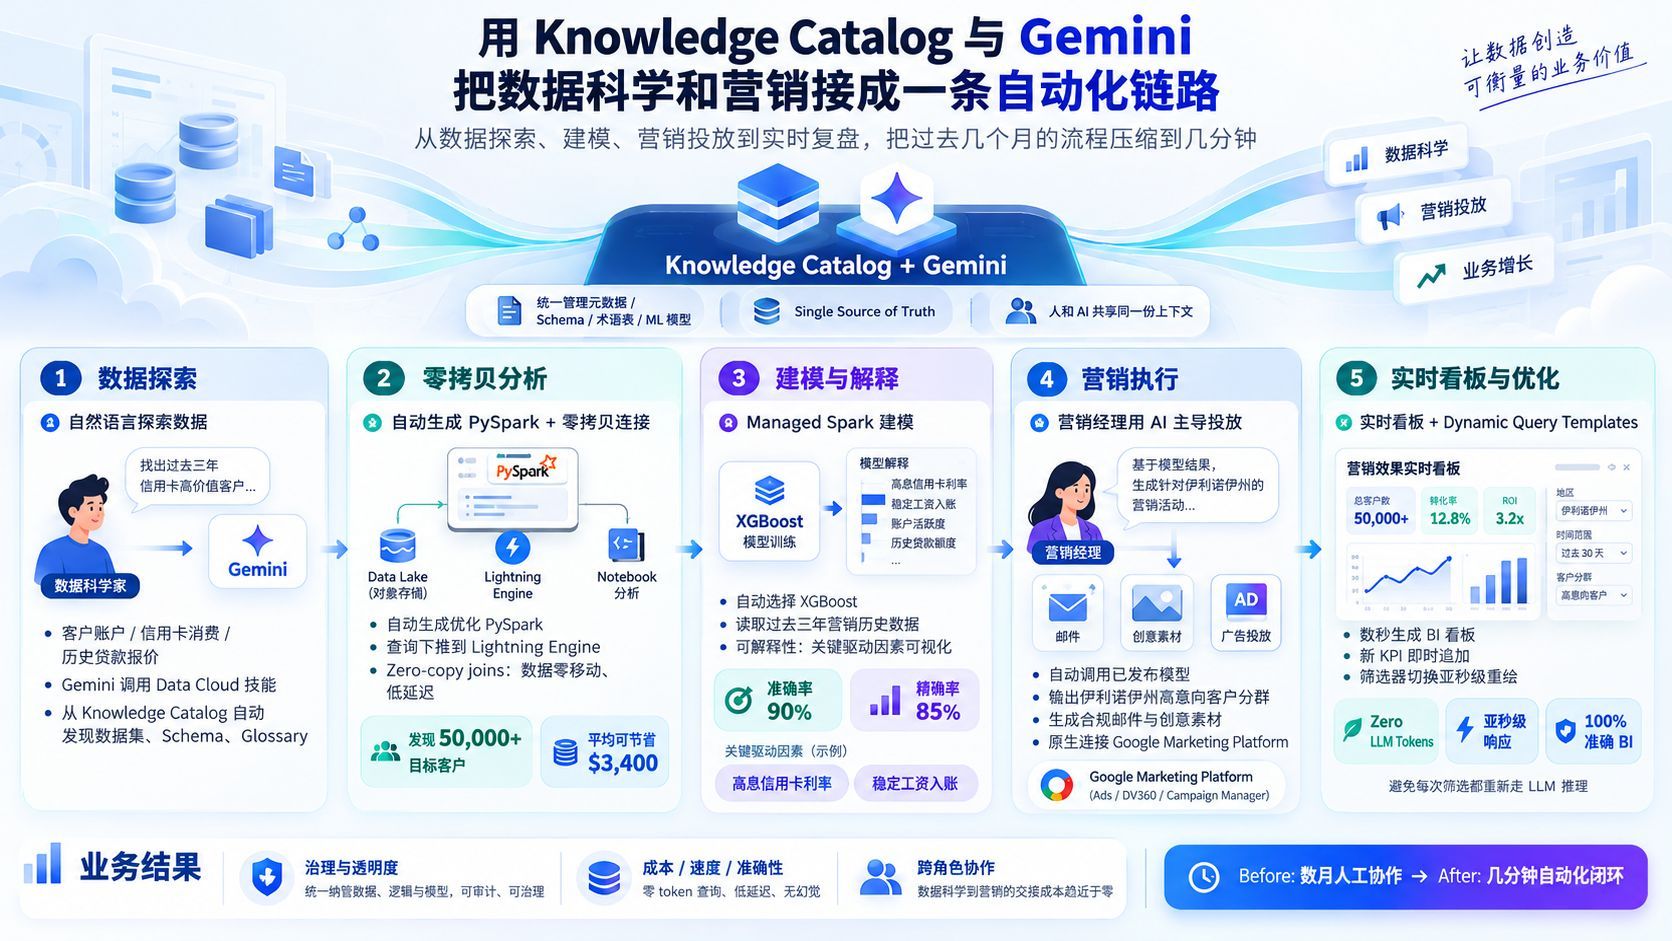
本文以零售银行的贷款置换为例,说明 Knowledge Catalog 与 Gemini 如何打通数据科学与营销:自然语言探索数据、自动生成 PySpark 并经 Lightning Engine 做零拷贝连接,用 XGBoost 建模(准确率90%、精确率85%),一键发布到目录,直至用零 token 的 BI 分析把数月工作压到几分钟。
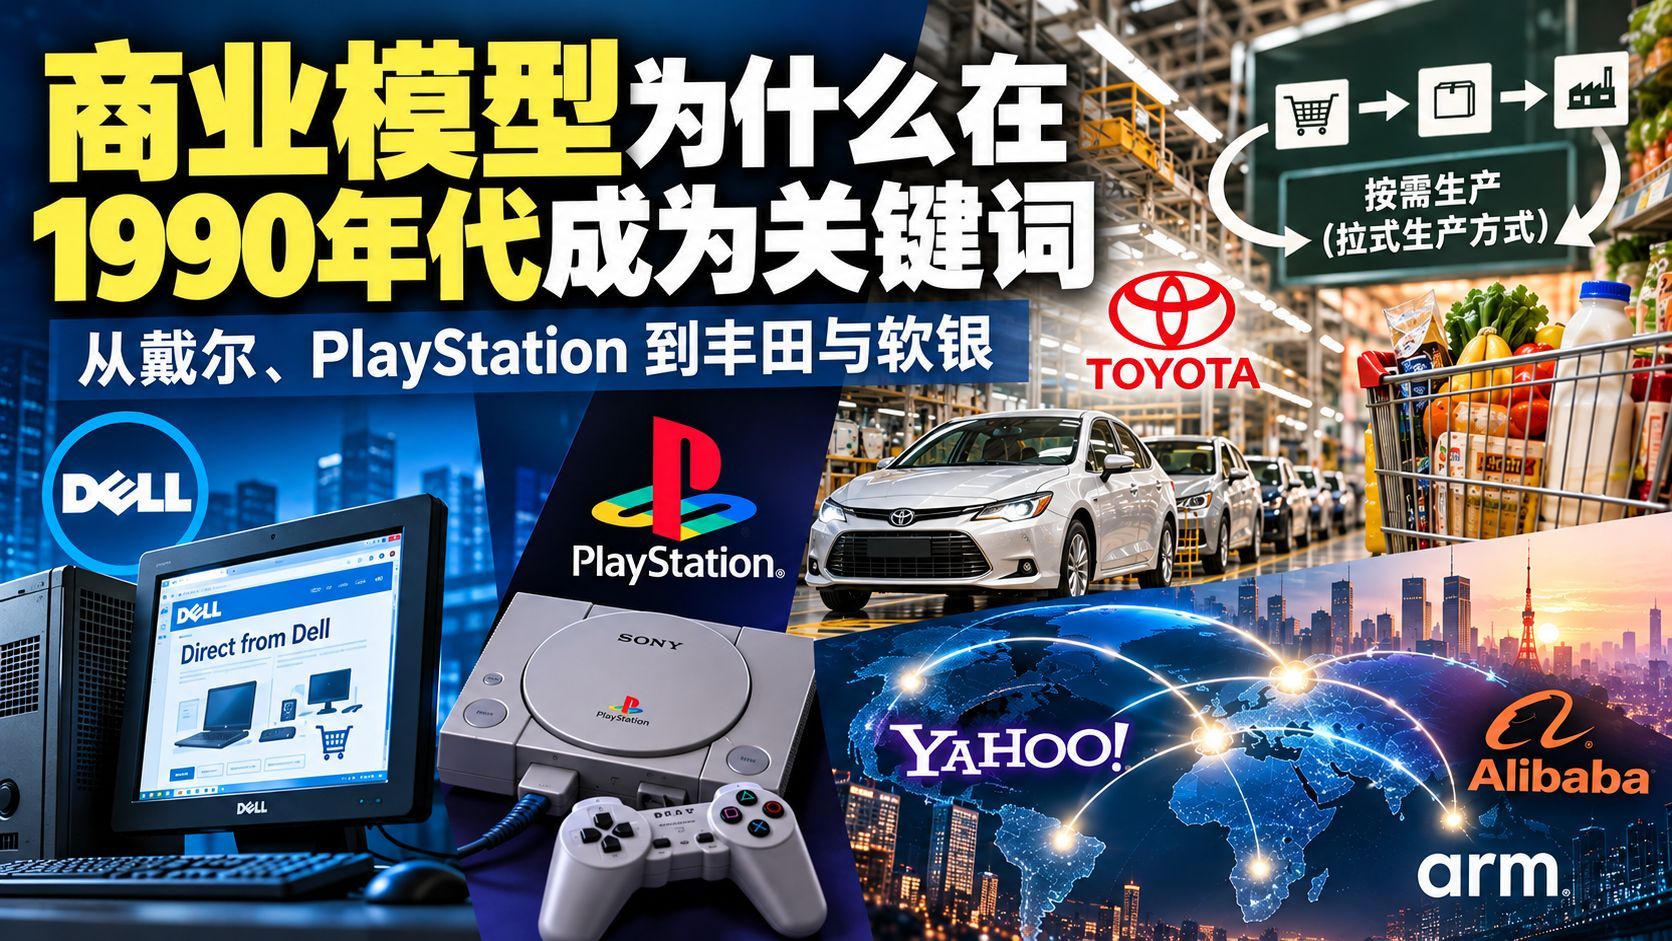
商业模型这个词是怎么流行起来的?本文从日本经济媒体的最早用例讲起:1995 年前后《日本经济新闻》围绕戴尔的报道、1997 年关于 PlayStation 否定任天堂商业模型的专题,以及半导体产业被美台追击的语境。之后回到丰田,梳理 Just-in-Time 与「自働化」两根支柱、推式生产的问题与拉式方式的由来,以及福特量产方式为何在日本过剩。最后介绍孙正义的「时光机经营」,并说明看商业模型没有唯一正确的切口。
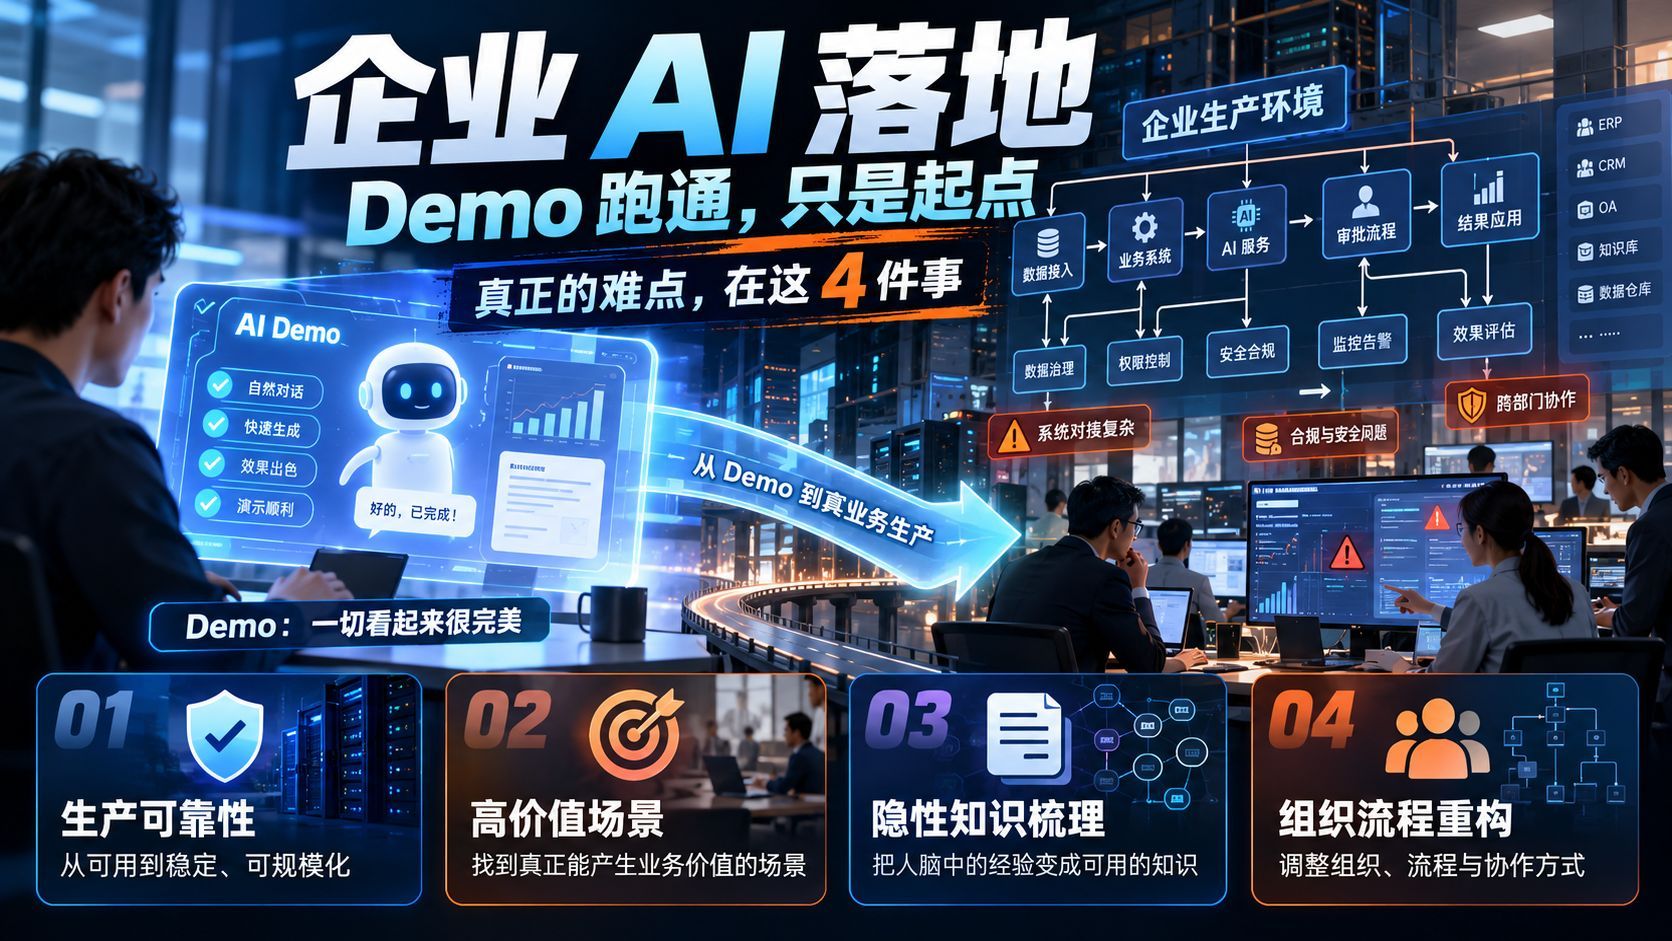
借腾讯研究院的 FDE 报告,梳理企业 AI 落地中反复出现的四个问题:把 Demo 跑通当成产品能上线、能做 AI 应用却没选对高价值场景、员工会做的事 AI 未必做得更好、个人提效不等于组织提效。文章结合智能客服与 ERP 的案例,说明 Demo 与生产之间的落差、隐性知识转化为上下文的必要性,并给出三点改进:不要用 Demo 速度推算落地周期、围绕高价值场景组织业务与技术共同负责的小团队、涉及流程职责与考核时高层必须亲自推动。
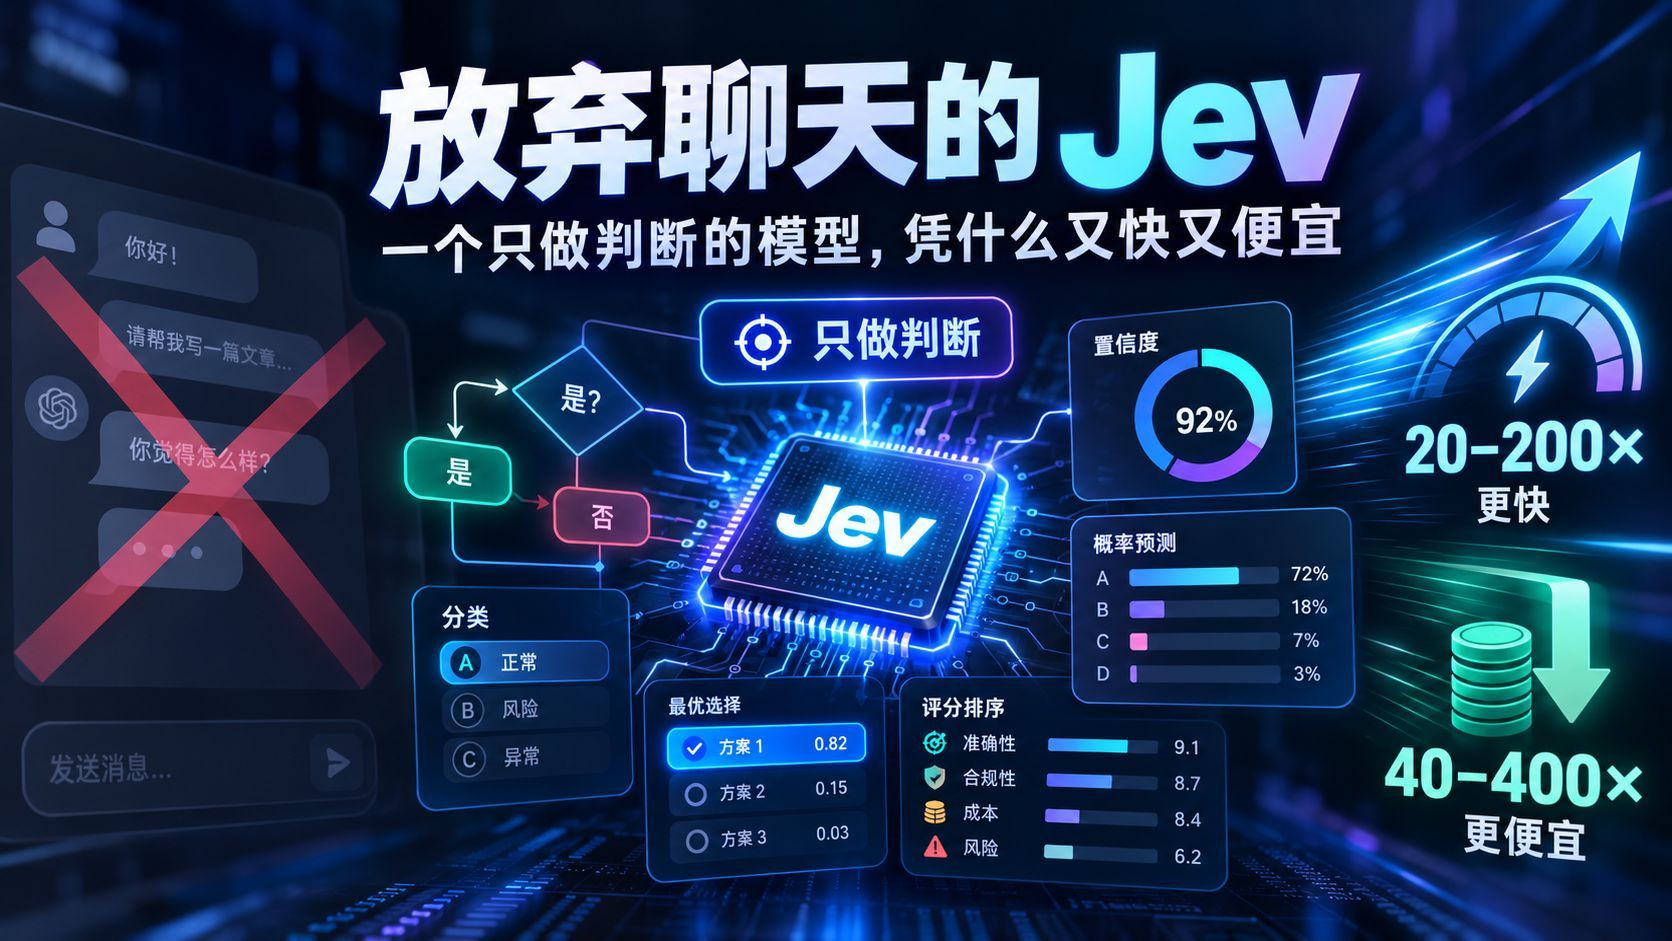
TypeSafe AI 的新模型 Jev 不写文章,只返回判断和概率:官方测试中速度最高约为通用大模型的 193.6 倍,成本约为其 1/444.6,每百万输入 token 仅 0.042 美元,输出免费。它用 state 和 question 调用,以 Noul、Choice、Score 三种形式输出结果,并采用 RLCD 让概率直接用于自动分流,体现了判断、生成、执行的分工。
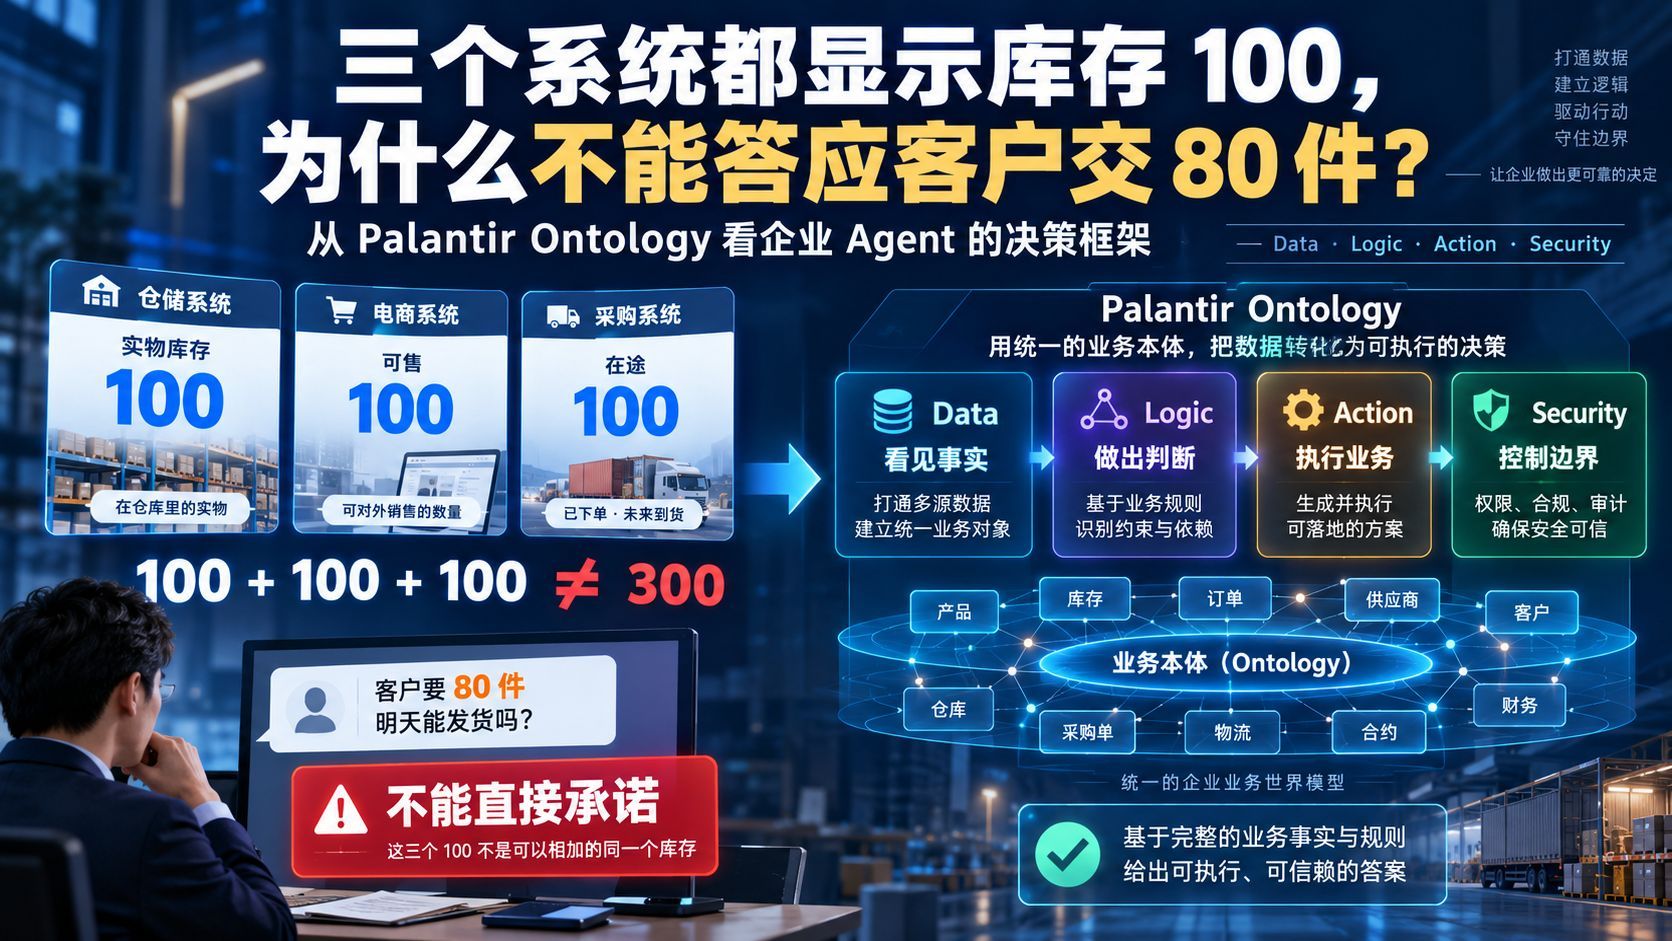
仓储、电商、采购三个系统各显示库存 100,加起来却不等于能交 300。Palantir 把真实业务决策拆成 Data、Logic、Action、Security 四部分,用 Object、Property、Link 描述业务世界,并让 AI 真正执行且受权限约束。本文用库存案例讲清 Ontology 的核心,并讨论大模型时代如何用 skills 与 MCP 复现这套理念:先做 Agent,再让 Ontology 随复杂度长出来。
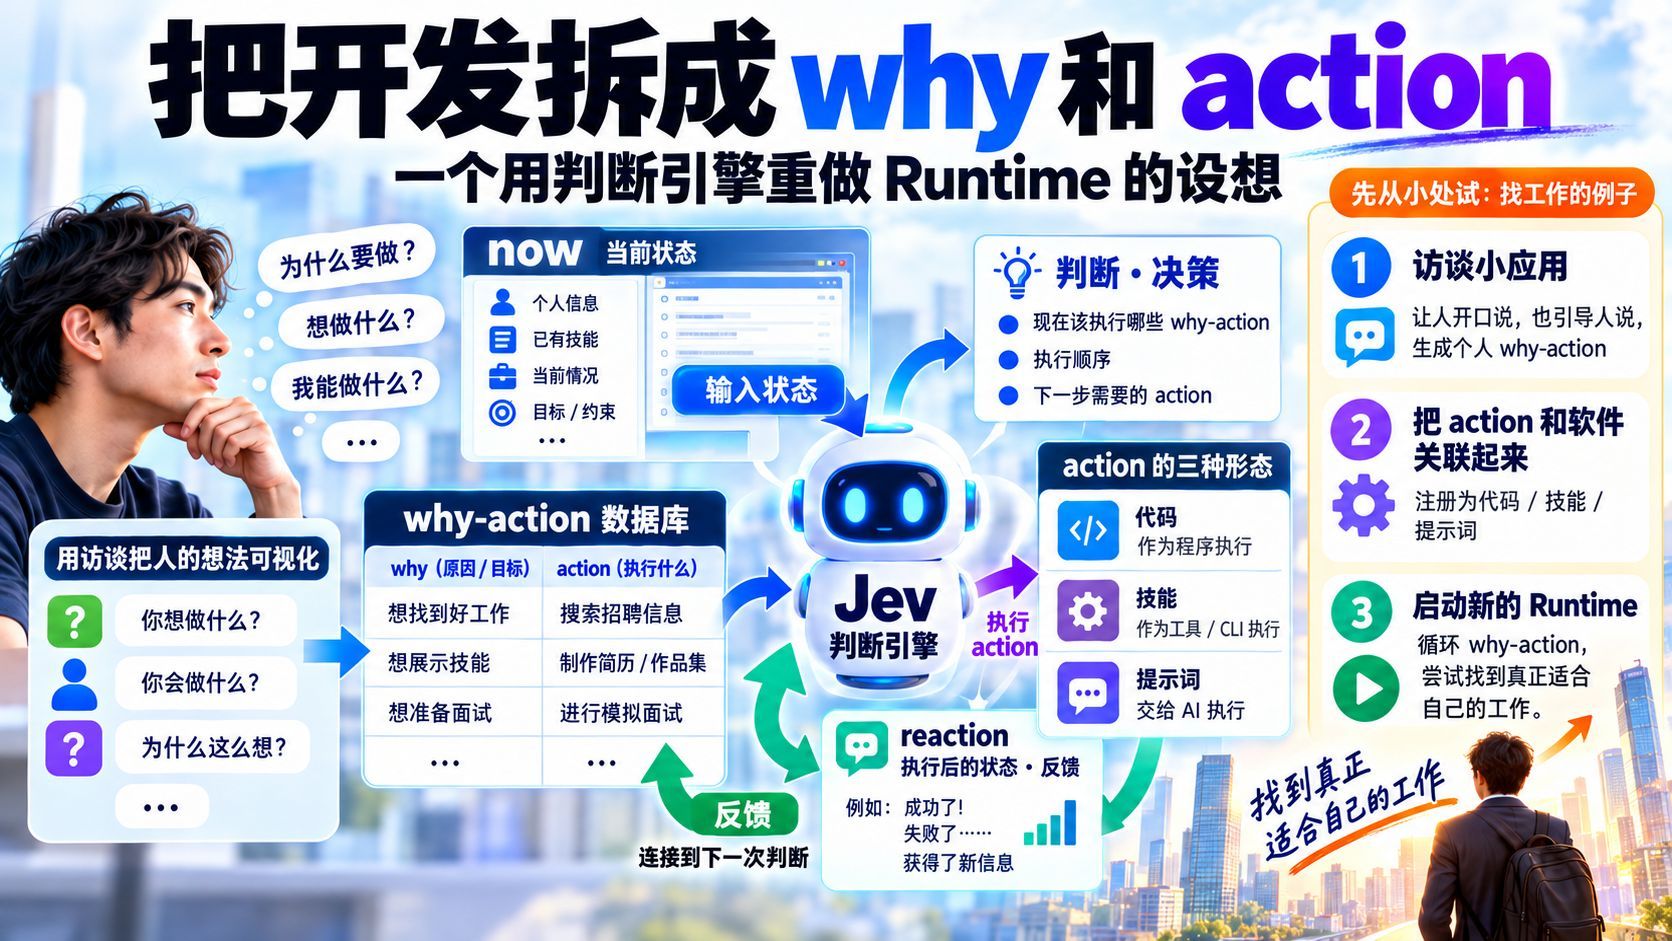
从 2026 年出现的判断引擎 JVE 出发,把开发抽象成 why 与 action 的 key-value,设想一套由 now 状态驱动的新 runtime:输入当前状态,判断该优先执行哪些 why-action、按什么顺序执行。再把 action 之后的 reaction 作为新输入触发下一个 Y,用类似 browser use 的方式监听 now,并借 interview 帮人建立自己的 why-action 数据库。最后把范围缩小到「帮你找工作」,拆成 interview 应用、action 与软件关联、runtime 循环三步来试。